案例说明
数据清洗是ETL流程中的核心环节之一,也是确保数据质量的关键步骤。在实际业务场景中,原始数据往往存在冗余字段、格式不统一、记录杂乱或拼写错误等问题,直接使用这些“脏数据”进行分析或建模会导致结论偏差甚至决策失误。因此,设计一套高效、可复用的数据清洗转换流程,是数据工程师必备的技能之一。
助睿ETL平台提供了丰富的清洗组件,能够以零代码拖拽的方式完成字段筛选、排序、条件过滤以及模糊匹配等操作,大大降低了数据处理的门槛。本实验聚焦两个典型场景:
-
场景一:对足球比赛数据进行字段筛选、排序和日期过滤 从原始比赛记录中剔除无用字段(如地区信息),按球队和赛事类型排序,并筛选出特定日期的比赛数据,以快速聚焦分析目标。
-
场景二:使用模糊匹配识别并纠正错误数据 通过将待校验的数据与标准参考数据进行模糊比对,计算相似度距离,从而发现可能的录入错误(如地名拼写错误),为后续数据修正提供依据。
适用场景:教学演练、开发测试、数据质量评估、数据预处理流水线搭建。
优点:操作直观,无需编程,组件复用性强,可快速构建清洗流程,适合高校教学及企业轻量级数据加工需求。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
/助睿数智(Uniplore)是AI驱动的一站式数据科学平台,覆盖从数据接入、ETL处理、机器学习建模到可视化展示的全链路零代码功能,适用于高校教学与企业数据加工场景。本次实验使用其核心子平台——助睿ETL数据集集成平台,体验零代码拖拽式数据清洗的便捷性与灵活性。
数据准备
本实验将使用以下三个数据文件,请提前从平台「公共空间」获取并上传至个人文件库中:
| 文件名 | 内容描述 | 用途 |
|---|---|---|
| matches.txt | 足球比赛记录,包含日期、球队、赛事类型、地区等字段 | 场景一:字段选择、排序、过滤 |
| states_of_usa.txt | 美国州名(可能含有不规范拼写) | 场景二:作为待校验数据源 |
| usa_city.txt | 标准美国州名及城市列表 | 场景二:作为标准参考数据源 |
所有文件均以分号(;)作为列分隔符,首行为列头。确保文件上传成功后,即可开始后续操作。
对数据进行字段筛选、排序与日期过滤
本小节将处理 matches.txt 文件。原始数据包含了多场比赛信息,其中 region 字段对于分析价值不大,我们将其移除;同时希望按球队名称和赛事类型排序,并只保留7月9日当天的比赛记录,以便快速了解该日各赛事情况。
操作步骤
1.新建转换并添加CSV文件输入组件
在助睿ETL平台中新建一个转换(工作流),从左侧「输入」面板中拖拽「CSV文件输入」组件至画布。
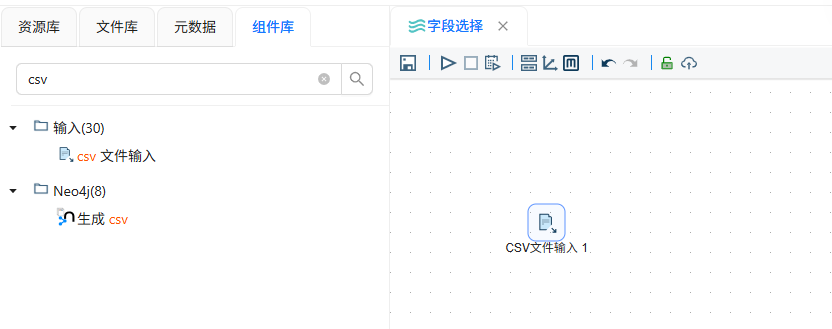
双击组件打开配置窗口:
单击「浏览文件」按钮,选择 matches.txt 文件。
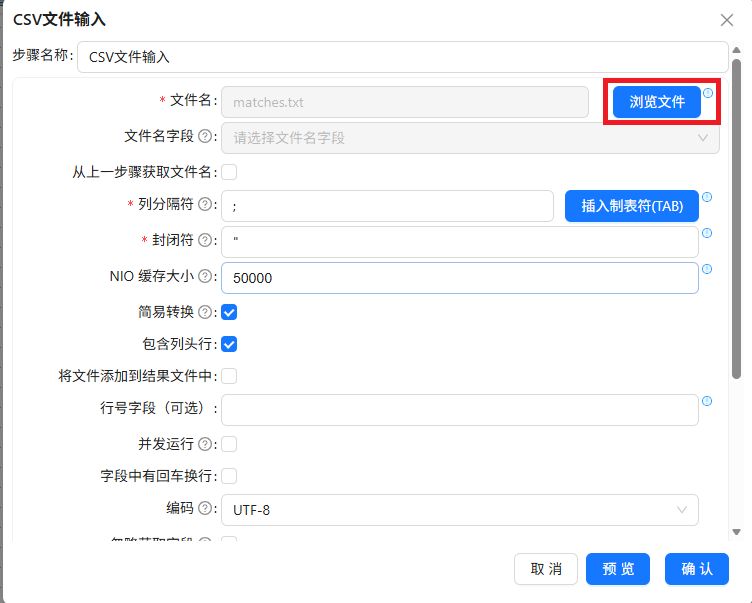
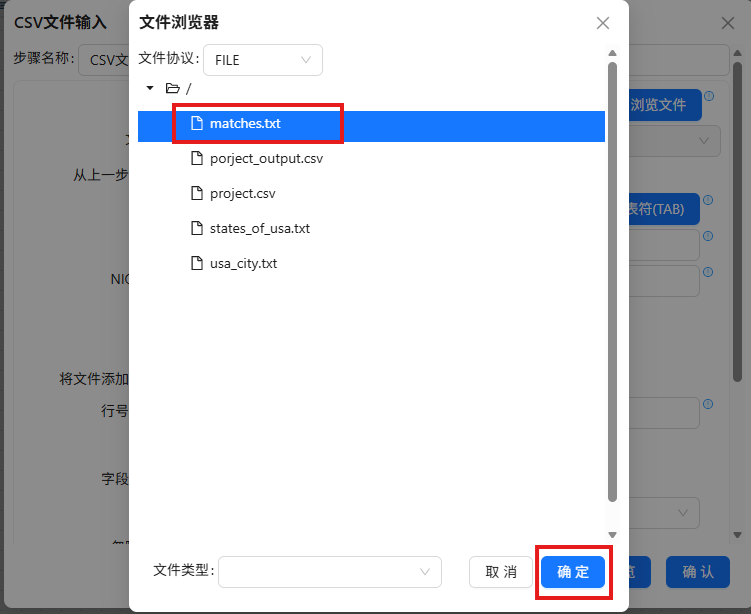
设置列分隔符为 ;(分号),其余参数保持默认(如编码UTF-8、包含列头行等)。
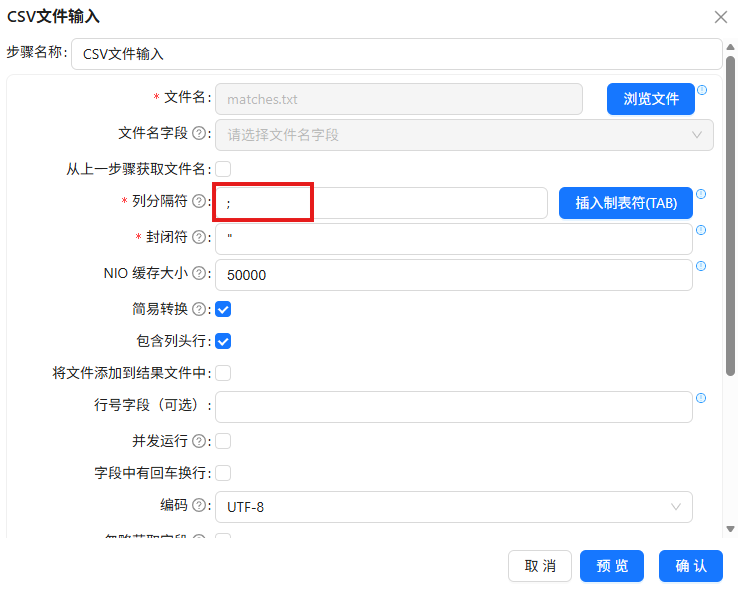
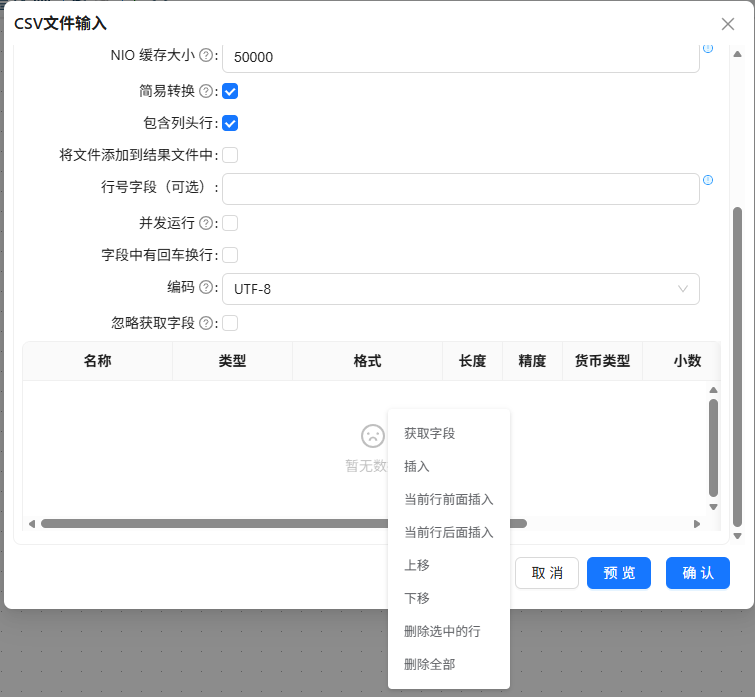
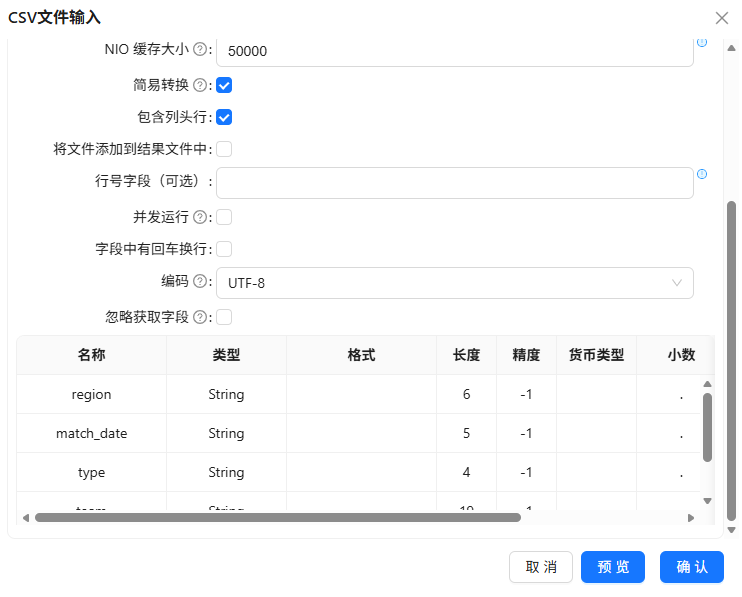
在下方字段表格区域点击鼠标右键,选择「获取字段」,系统自动读取文件头部并解析出所有字段名称与类型。
配置完成后点击「确认」保存。
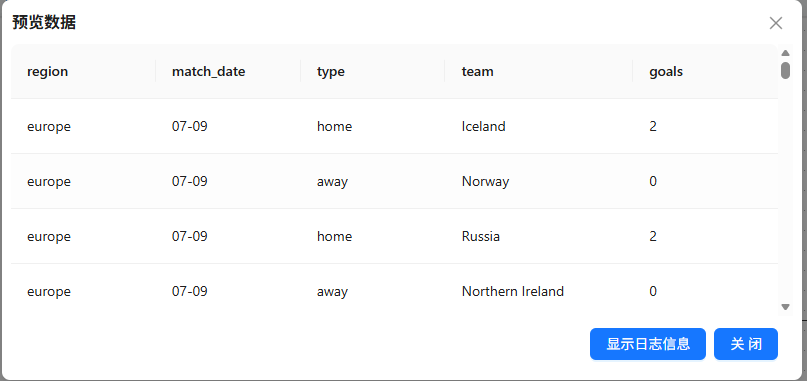
2.预览原始数据
选中该组件,右键点击「预览输出」,查看数据是否正常读取。预览结果应展示完整的比赛记录,包含 match_date、team、type、region 等字段,共计242条记录。
3.删除冗余字段(字段选择组件)
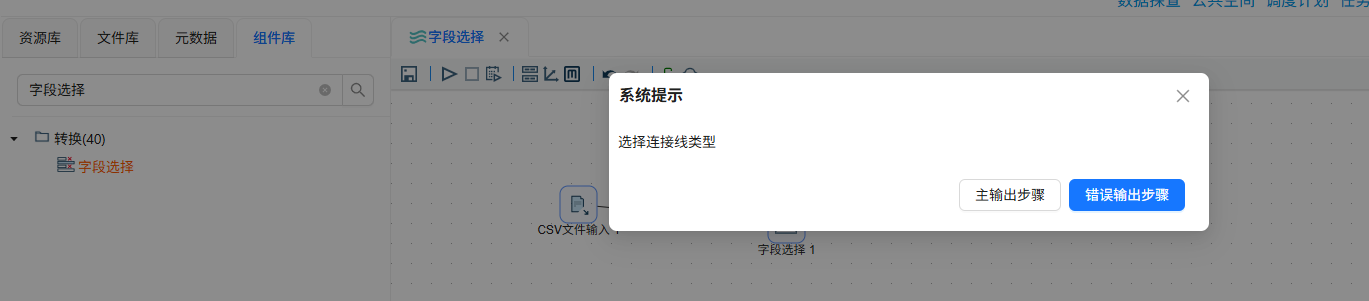
从「组件库」面板拖拽「字段选择」组件至画布,并将上游CSV输入组件的输出连接至该组件(选择主输出步骤)。
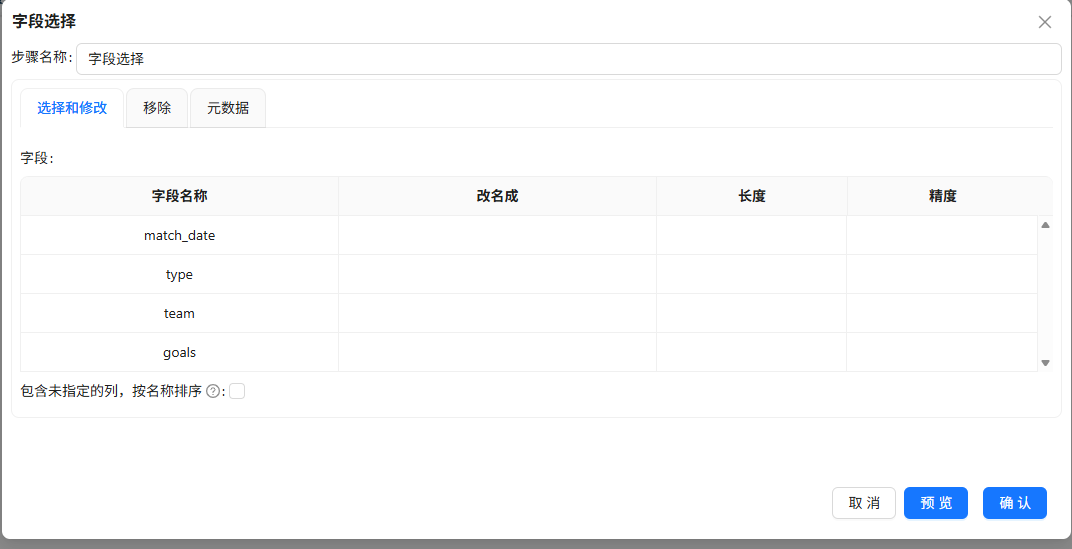
双击「字段选择」组件,在「选择和修改」标签页的表格区域右键点击「获取字段」,同步所有字段列表。此时,您会看到所有字段名。选中 region 这一行,点击「删除选中的行」将其移除,保留其余所有字段。此操作有助于精简数据集,减少后续处理负担。
确认无误后点击「确认」保存配置。
4.按球队和赛事类型排序(排序记录组件)
从「组件库」面板拖拽「排序记录」组件至画布,连接上一个字段选择组件。
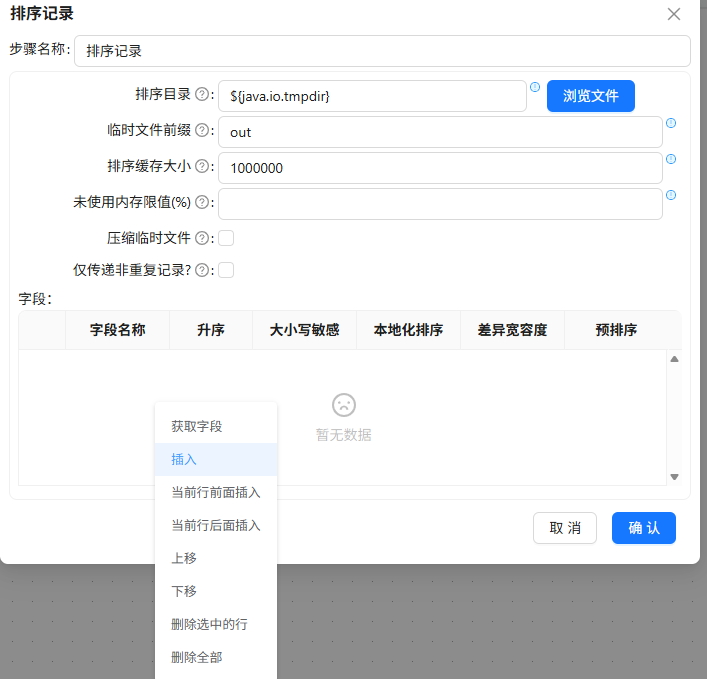
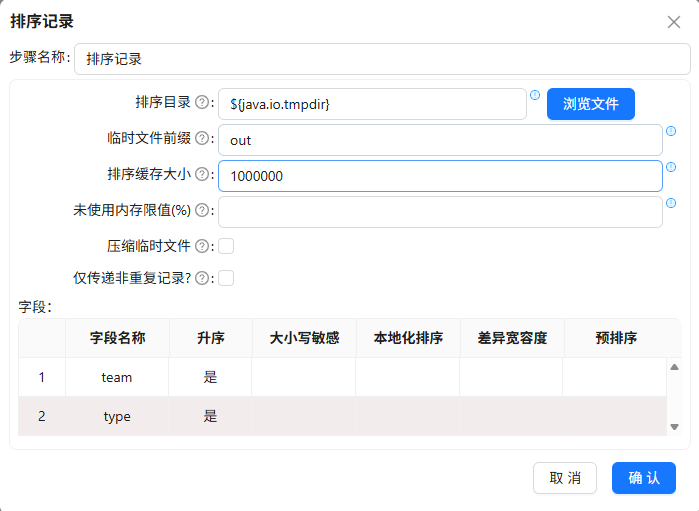
双击「排序记录」组件,在下方空白处右键选择“插入”。分别添加 team 和 type 两个字段,并将两者的排序顺序均设为“升序(Ascending)”。这样输出结果将首先按球队名称字母排序,同球队内再按赛事类型排序,便于对比分析。
点击「确认」保存。
5.添加过滤条件与空操作组件
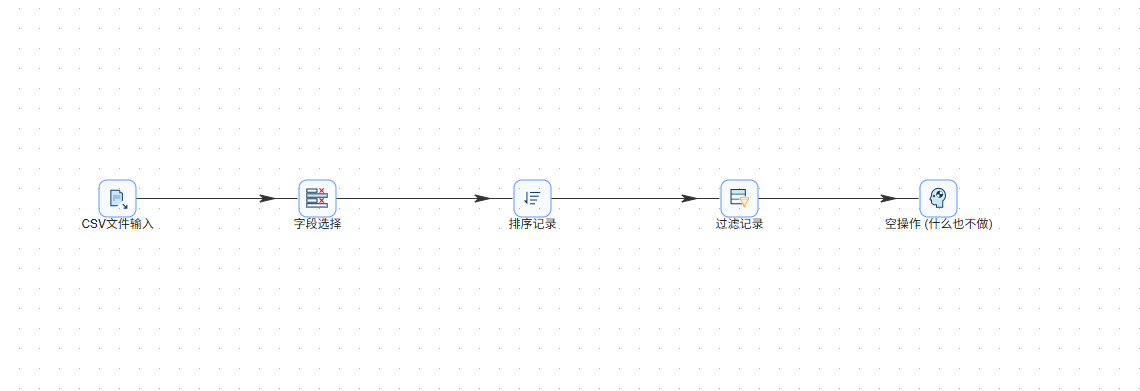
从「组件库」面板拖拽「过滤记录」组件和「空操作(什么也不做)」组件至画布。按以下顺序连接:排序记录 → 过滤记录 → 空操作。所有连接均采用主输出步骤。
此时转换的整体流程如图所示:
6.配置过滤条件
双击「过滤记录」组件,在左侧条件设置区域选择字段 match_date,运算符选择“=”,值输入 07-09。该配置将只保留比赛日期为7月9日的记录,过滤掉其他日期的数据。
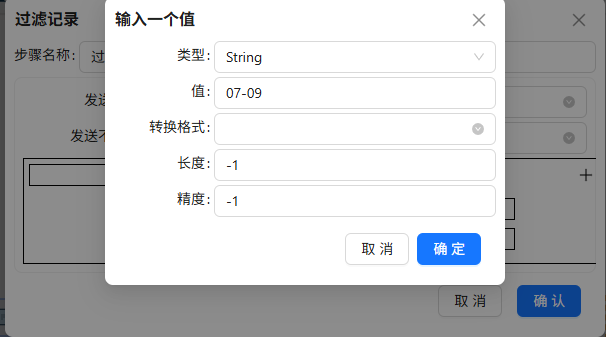
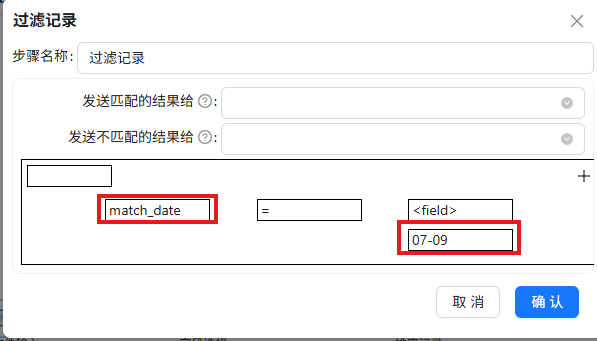
点击「确认」保存。
7.运行转换并验证结果
点击画布左上角的「运行」按钮,在弹出的对话框中点击「启动」执行转换。运行完成后,可查看执行日志,确认各步骤处理记录数。
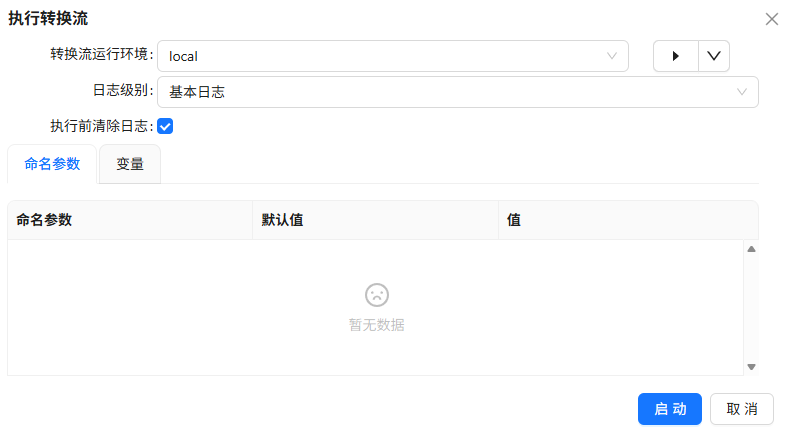
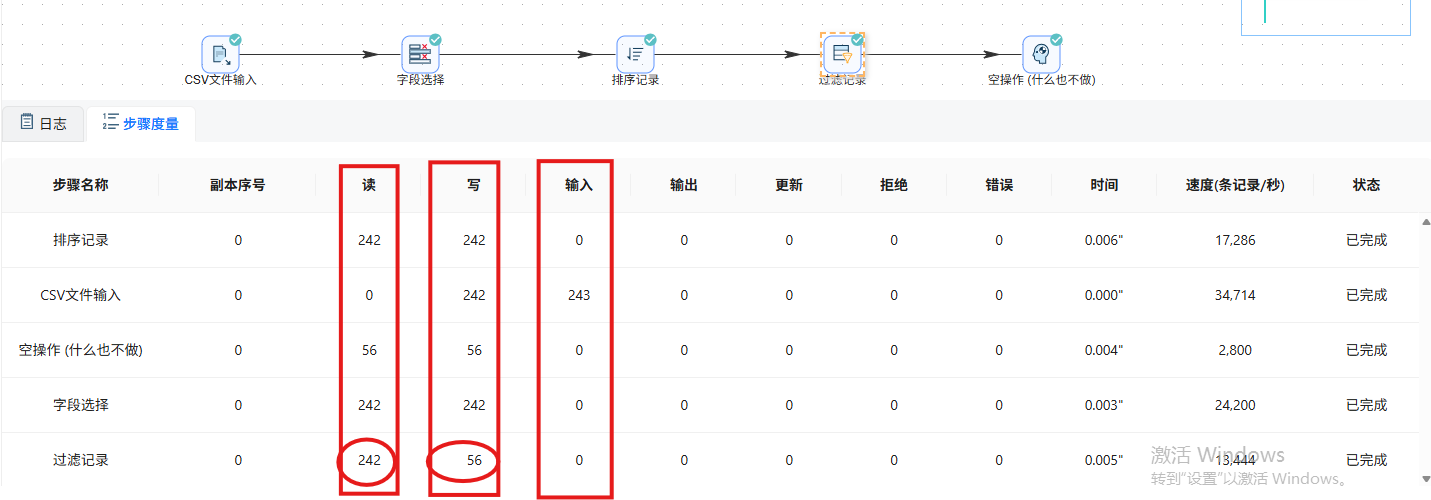
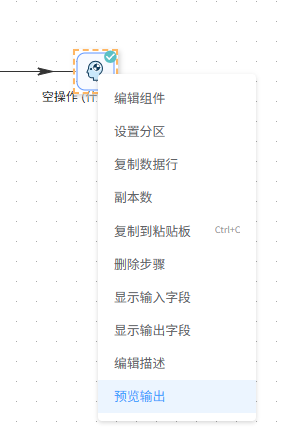
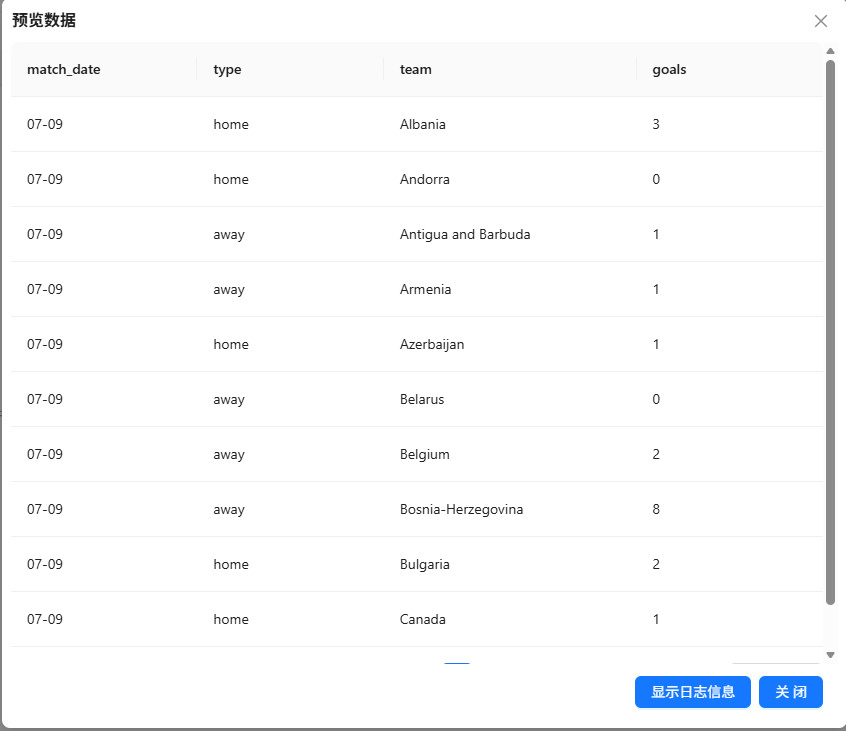
选中最后的「空操作」组件,右键点击「预览输出」。您将看到最终结果:
-
region字段已被移除; -
记录已按
team、type升序排列; -
仅包含
match_date = 07-09的记录(预期56条,原始242条中的过滤结果)
使用模糊匹配检验错误数据
本小节将演示如何利用助睿ETL的「模糊匹配」组件,找出可能输入错误的州名。我们将以一个包含潜在拼写错误的州名文件(states_of_usa.txt)作为待校验源,另一个标准的州名城市文件(usa_city.txt)作为参考,通过计算字符串之间的相似度(距离),识别出异常数据,为后续修正提供参考。
操作步骤
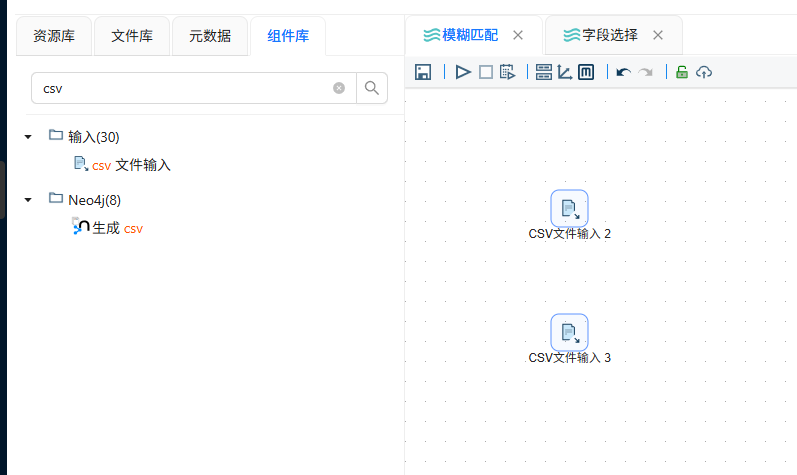
1. 添加两个CSV文件输入组件
从「输入」面板中拖拽两个「CSV文件输入」组件到画布,分别用于读取待校验数据和标准参考数据。
2. 配置第一个CSV文件输入(待校验数据)
双击第一个CSV输入组件,选择文件 states_of_usa.txt,分隔符设为 ;。
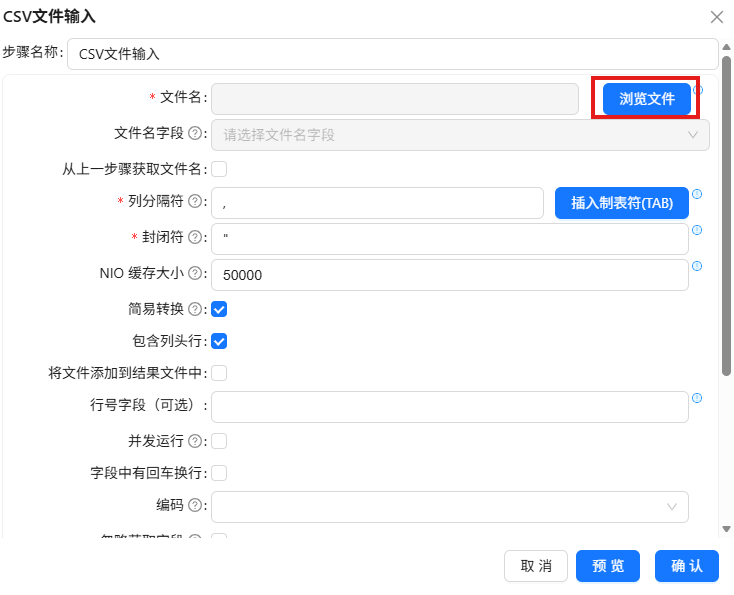
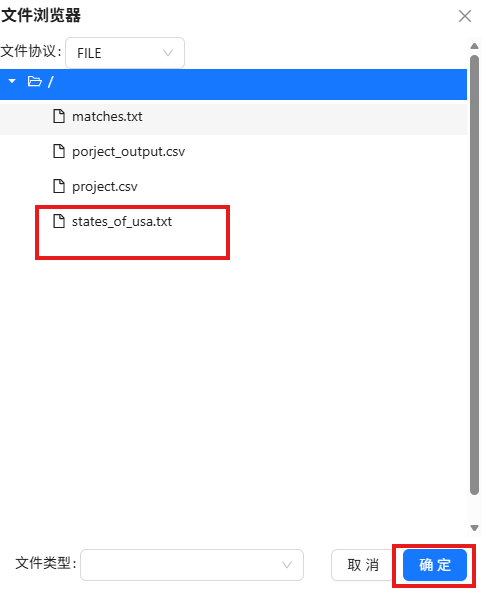
然后在表格区右键「获取字段」解析字段结构。该文件通常包含一个州名字段,记录可能存在大小写、拼写差异。
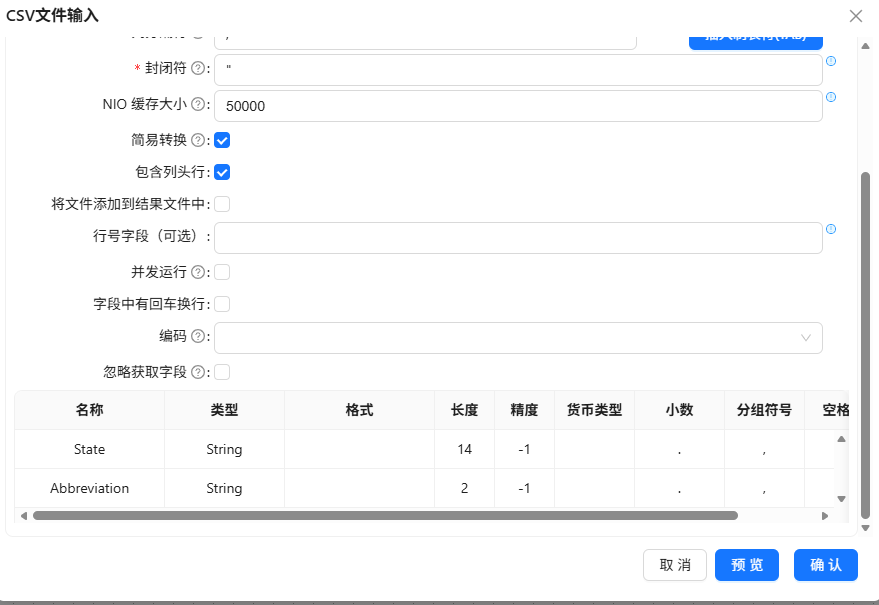
点击「确认」保存。
3.配置第二个CSV文件输入(标准参考数据)
双击第二个CSV输入组件,选择文件 usa_city.txt,分隔符同样设为 ;,右键「获取字段」解析字段。该文件包含标准的州名或城市名,作为匹配基准。
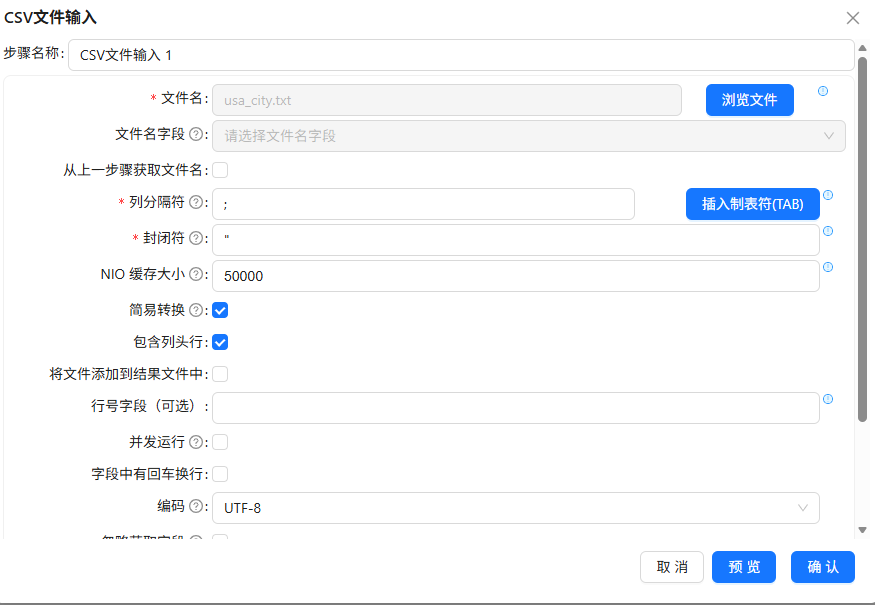
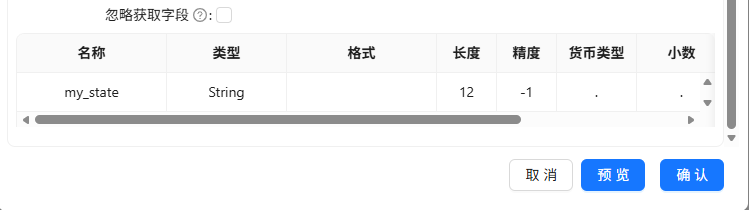
点击「确认」保存。
4.添加模糊匹配组件并连线
从「应用」面板拖拽「模糊匹配」组件至画布。连线方式如下:
-
将第一个CSV输入(待校验数据)连接到模糊匹配的主输入步骤;
-
将第二个CSV输入(标准参考数据)连接到模糊匹配的查找输入步骤。
连线均选择主输出步骤。
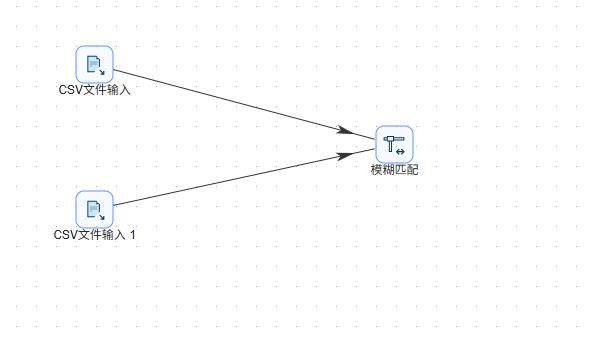
5.配置模糊匹配参数
双击「模糊匹配」组件,进入配置界面:
在基本配置页面,选择要匹配的字段,设置匹配算法(默认即可)。
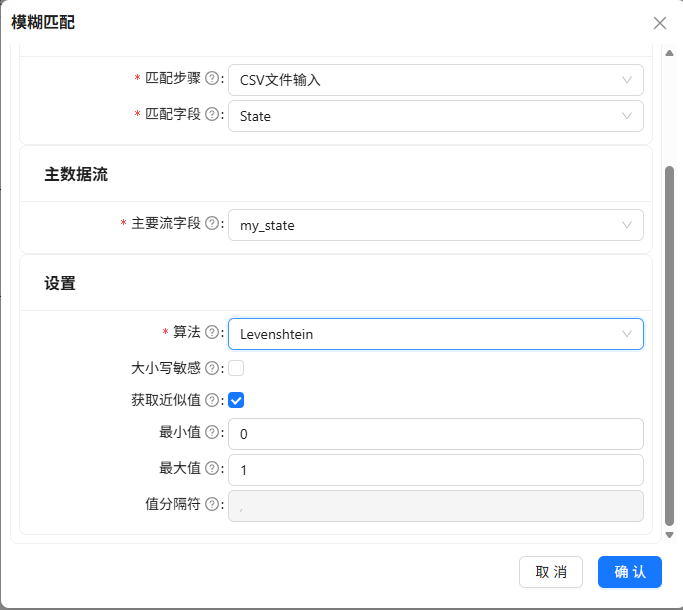
切换到「字段」标签页,在「匹配字段」字段文本框中输入 match(该字段将输出匹配度),在「值字段」文本框中输入 measure value(该字段将输出距离值,距离越小表示越相似)。
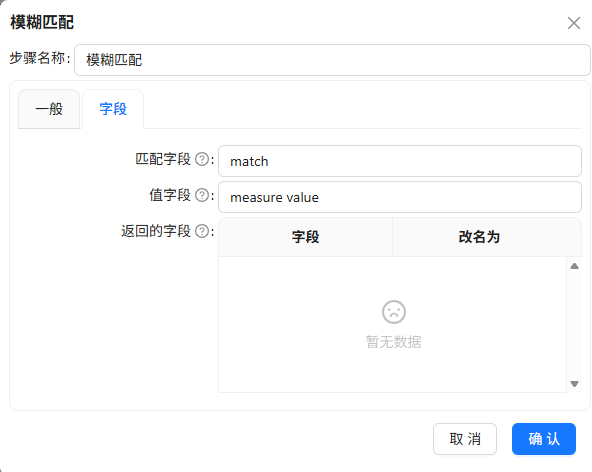
其他参数保持默认,点击「确认」保存。
6.运行转换
点击「运行」按钮启动流程。执行完成后,系统会将每条待校验记录与所有标准记录进行比对,并生成匹配结果。
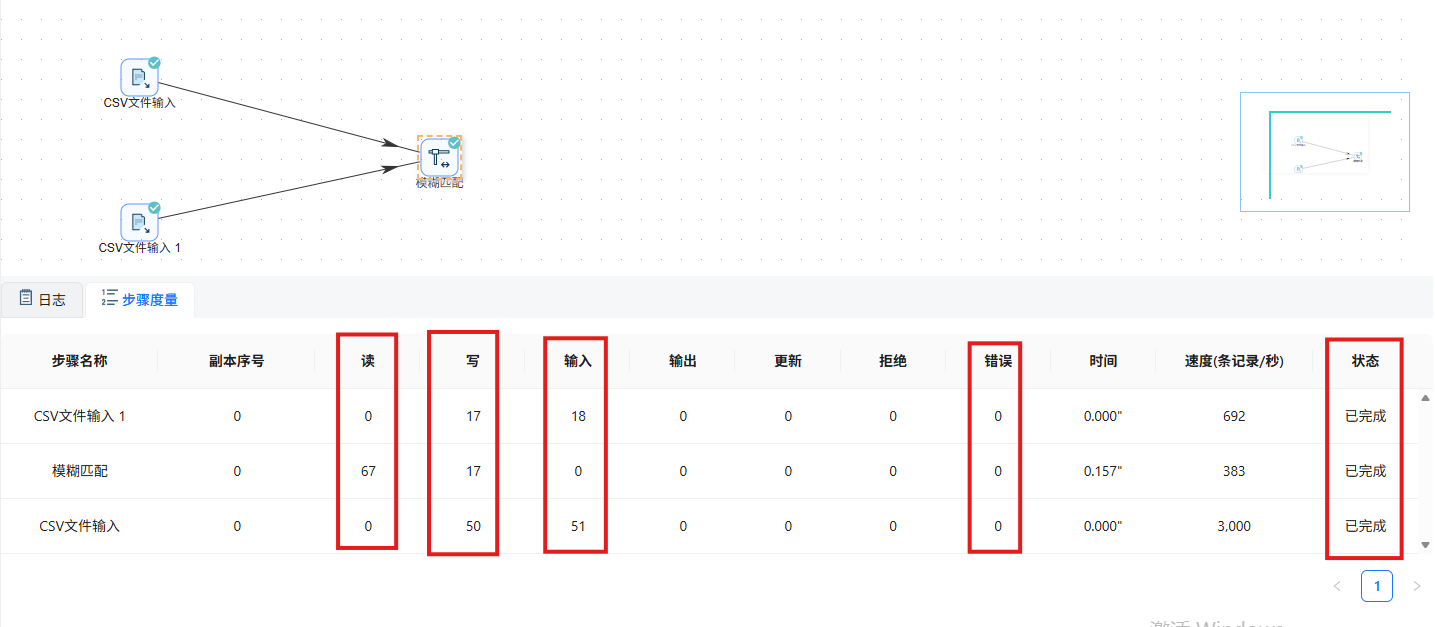
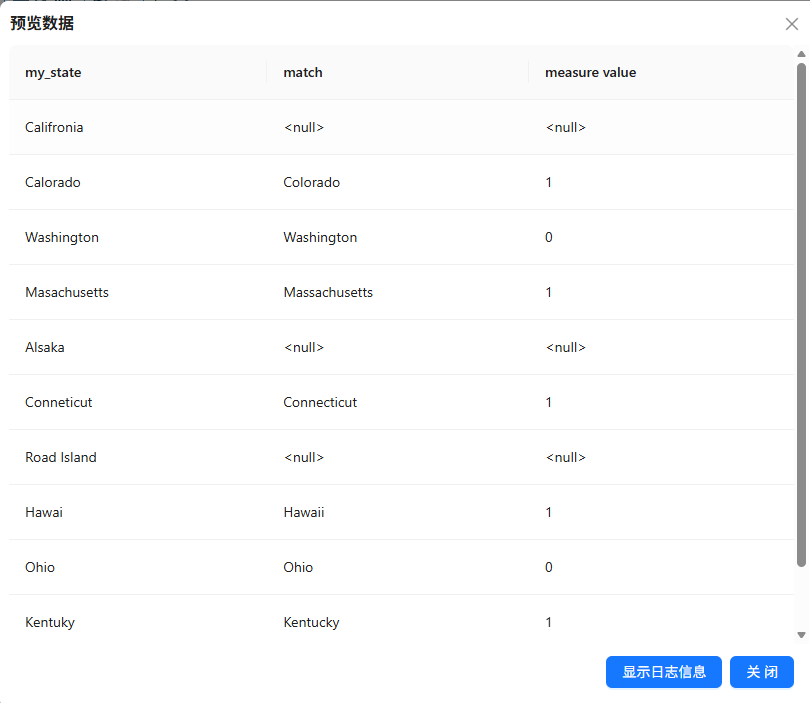
7.选中「模糊匹配」组件,右键点击「预览输出」。预览数据将展示:
-
原始待校验的州名;
-
与之最匹配的标准州名;
-
match字段(匹配度)和measure value字段(距离值)。
通过距离值的大小,您可以快速识别出疑似错误的记录(例如距离值较大的记录),并据此进行人工复核或自动修正。