案例说明
在数据集成与数据清洗的实际业务场景中,我们经常需要借助外部的主数据或参照数据(也称为字典表)来校验、补充或修正原始数据。这类需求非常普遍,例如:更正地址信息、校验邮政编码与城市的匹配关系、统一不同业务系统中的编码规范等。
以地址清洗为例,基础数据类的应用通常依赖标准化的国家名、州名、城市名和邮政编码。然而,很多业务系统(如客服系统、CRM系统)允许用户通过文本输入的方式录入信息,这就导致了大量不规范的输入数据:拼写错误、格式不统一、邮政编码与城市名不匹配等问题层出不穷。为了清理这些数据,就需要将文本方式输入的内容与主数据中的标准化记录进行匹配。
参照表清洗的核心价值在于:
-
数据校验:通过参照表验证输入数据的正确性,标记异常记录;
-
数据补全:根据参照表为原始数据补充缺失的标准字段;
-
编码映射:将不同源系统的异构编码统一映射为规范编码,实现数据整合;
-
错误识别:通过相似度计算发现拼写错误和完整性缺失。
本实验将通过两个典型场景,演示如何使用助睿ETL的「流查询」、「计算器」、「模糊匹配」、「过滤记录」等组件完成参照表清洗任务:
-
场景一:使用参照表清洗地址信息 —— 通过邮政编码查询城市名,并结合模糊匹配校验地址的准确性;
-
场景二:参照表清洗性别编码 —— 将不同源系统的异构性别编码统一映射为标准编码。
适用场景:数据质量管理、主数据管理、数据集成与迁移、用户输入数据清洗。
优点:通过参照表标准化数据,提高数据一致性;利用模糊匹配识别近似错误,降低人工复核成本;流程可复用,易于扩展至其他参照表清洗需求。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
助睿数智(Uniplore)是AI驱动的一站式数据科学平台,覆盖从数据接入、ETL处理、机器学习建模到可视化展示的全链路零代码功能,适用于高校教学与企业数据加工场景。本次实验使用其核心子平台——助睿ETL数据集集成平台,体验零代码拖拽式参照表清洗的完整流程。
数据准备
本实验将使用以下数据:
| 数据文件/内容 | 用途说明 |
|---|---|
| 自定义常量数据(模拟源数据) | 场景一:包含ID、姓名、地址、邮政编码、城市字段的模拟地址数据 |
| 自定义常量数据(模拟参照表) | 场景一:包含邮政编码四位数字与对应城市名称的参照数据 |
| regulatory_checklist.csv | 场景二:包含异构性别编码的业务数据 |
| dim_area_mapping.csv | 场景二:包含标准编码与标准名称的映射参照数据 |
说明:场景一使用「自定义常量数据」组件在平台内直接生成数据,无需外部文件;场景二请提前从平台「公共空间」获取并导出至个人文件库中:
操作前请确保已登录助睿ETL平台,并可正常访问文件库与组件库。
使用参照表清洗地址信息
本小节将以地址信息清洗为例,演示如何使用参照表校验邮政编码与城市名称的匹配关系。我们将使用「自定义常量数据」组件模拟生成源数据与参照表数据,通过「计算器」组件提取邮政编码中的数字部分,使用「流查询」组件根据编码查询参照表中的城市名,最后利用「模糊匹配」算法计算原始城市名与参照城市名的相似度,从而识别出可能的错误记录。
操作步骤
1.新建转换并添加自定义常量数据(源数据)
新建转换工作流,从组件库面板中拖拽「自定义常量数据」组件至画布。双击组件,在「步骤名称」中输入 SourceData。
配置元数据:切换到「元数据」标签页,手动定义以下五列数据:
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}| 字段名 | 类型 | 说明 |
|---|---|---|
| ID | Integer | 记录唯一标识 |
| Name | String | 姓名 |
| Address | String | 详细地址 |
| PostalCode | String | 邮政编码 |
| City | String | 城市名称 |
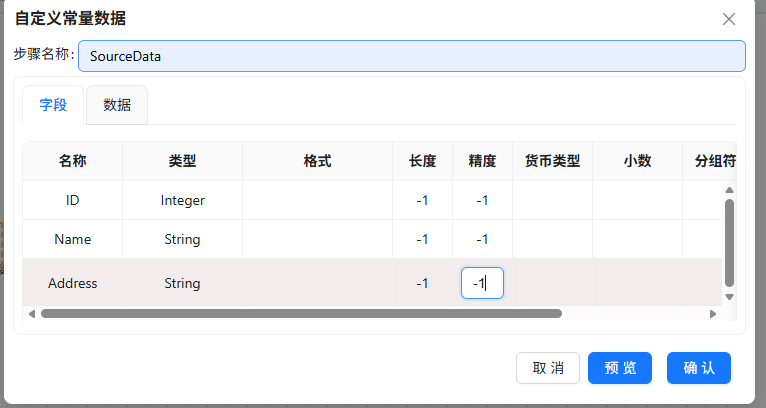
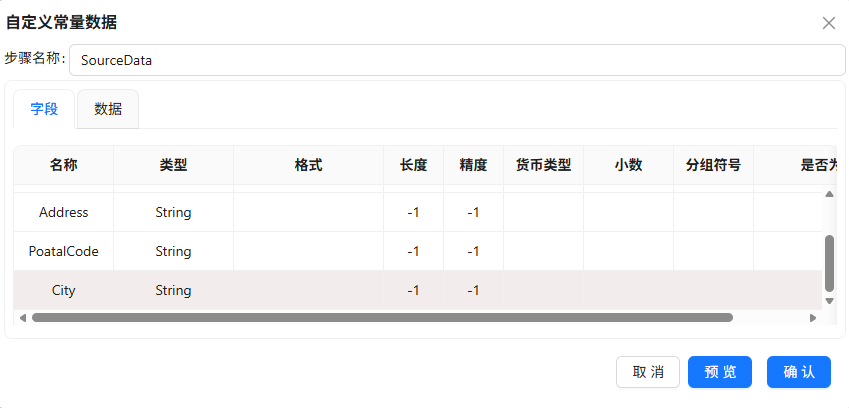
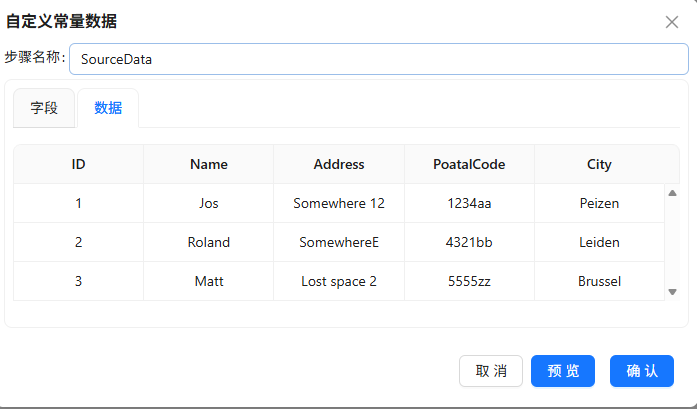
2.录入数据:切换到「数据」标签页,输入三条模拟地址记录
3.添加计算器组件
原始邮政编码中可能包含字母或特殊字符(如 5555 AB),而参照表中的查询键通常是纯数字。因此,需要从邮政编码中提取纯数字部分。
从「组件库」面板拖拽「计算器」组件至画布,将 SourceData 组件的输出连接至该组件。
双击组件,配置如下:
-
步骤名称:
getPC4 -
新字段名:输入
PC4(表示提取出的四位邮政编码数字) -
计算规则:选择
Return only digits from string A(仅返回字符串A中的数字) -
字段A:选择
PostalCode -
值类型:Number
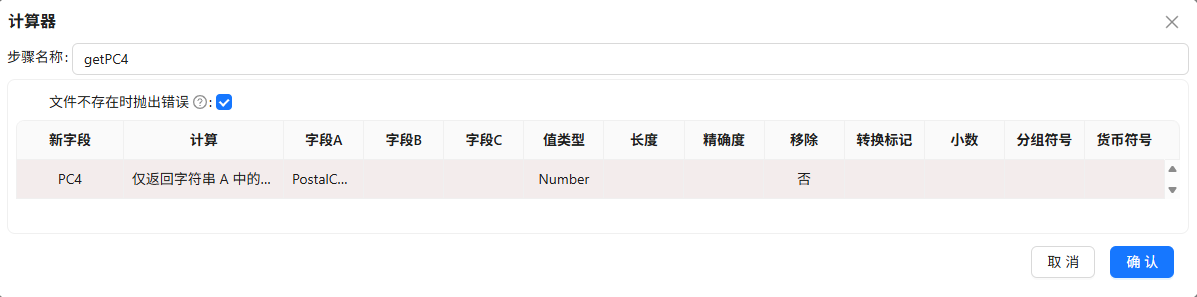
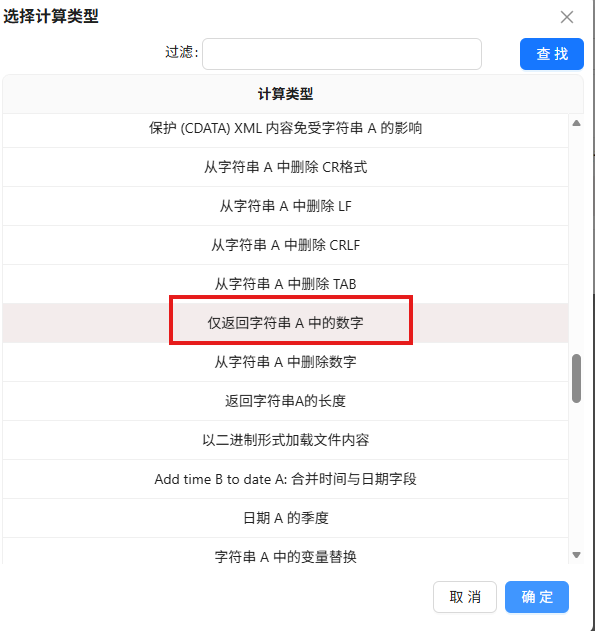
配置完成后点击「确认」。
3.添加第二个自定义常量数据(模拟参照表)
从「组件库」面板拖拽第二个「自定义常量数据」组件至画布,用于模拟邮政编码参照表。
双击组件,步骤名称填入 PC4。
配置元数据:在「元数据」标签页定义以下字段:
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}| 字段名 | 类型 | 说明 |
|---|---|---|
| PC4 | String | 四位邮政编码数字(查询键) |
| RefCity | String | 标准城市名称 |
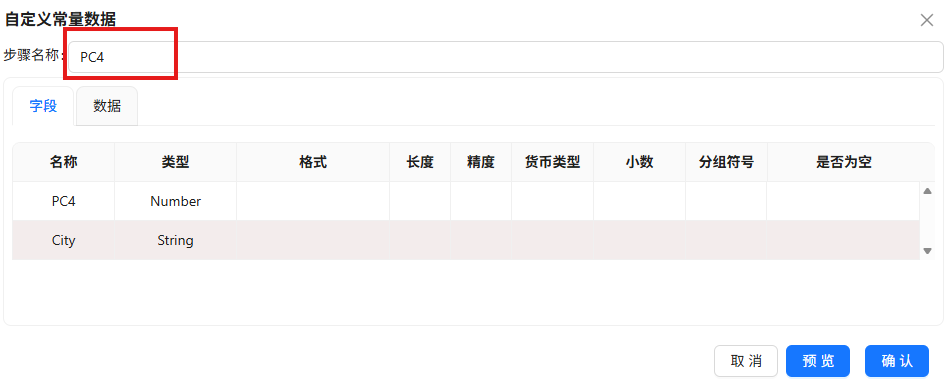
录入数据:切换到「数据」标签页,输入参照数据,例如:
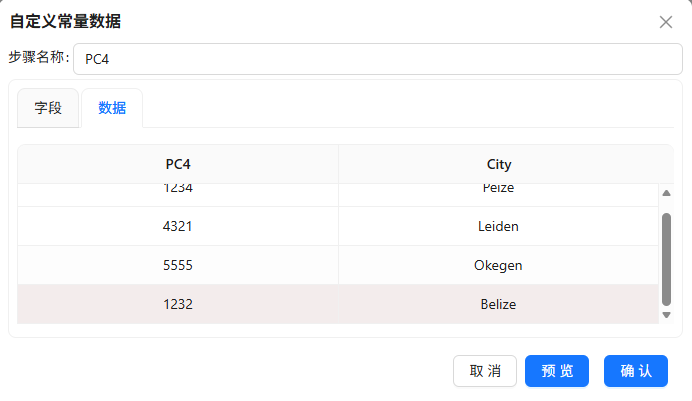
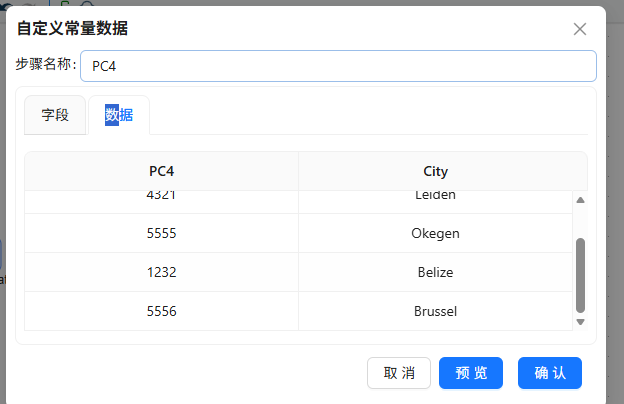
点击「确认」保存。
4.添加流查询组件(查询参照表获取标准城市名)
现在需要将源数据中的邮政编码(已提取为PC4)与参照表中的PC4进行匹配,获取对应的标准城市名。
从「组件库」面板拖拽「流查询」组件至画布,将 getPC4 步骤和 PC4 步骤都连接到 流查询 组件(注意:getPC4 作为主输入,PC4 作为参照输入)。
双击「流查询」组件,按以下配置:
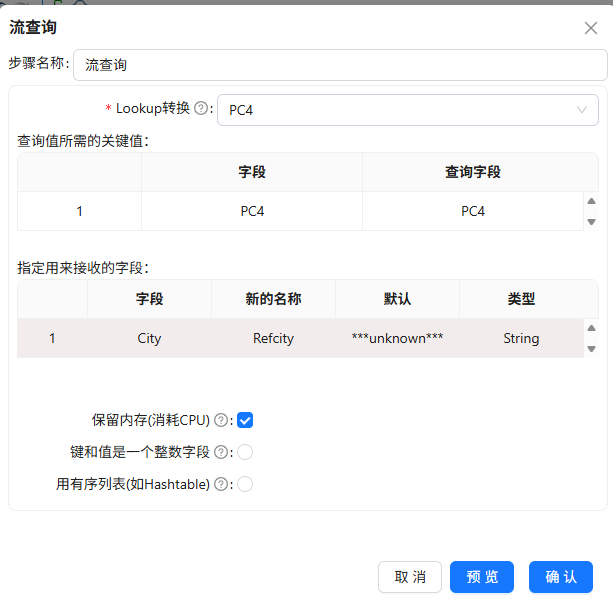
设计要点:为查询不到的数据设置一个容易识别的默认值(前后缀均为
***),这样在后续检查数据时可以快速定位未匹配的记录,且该默认值不会与任何真实城市名产生相似度。
5.添加第二个计算器组件(模糊匹配计算相似度)
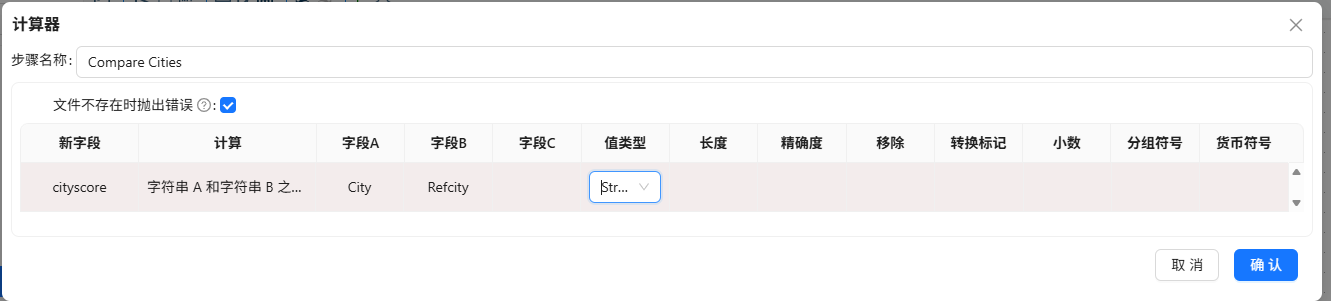
为了检测原始城市名与参照标准城市名是否存在拼写错误或不一致,使用 Jaro-Winkler 算法计算两者之间的相似度。
从「组件库」面板拖拽第二个「计算器」组件至画布,将 流查询 组件的输出连接至该组件。
双击组件,配置如下:
-
步骤名称:
Compare Cities -
新字段名:输入
cityscore -
字段A:选择
City(原始城市名) -
字段B:选择
RefCity(参照标准城市名) -
计算规则:选择
JaroWinkler similitude between String A and String B(Jaro-Winkler相似度算法)
6.添加空操作组件并连接完整流程
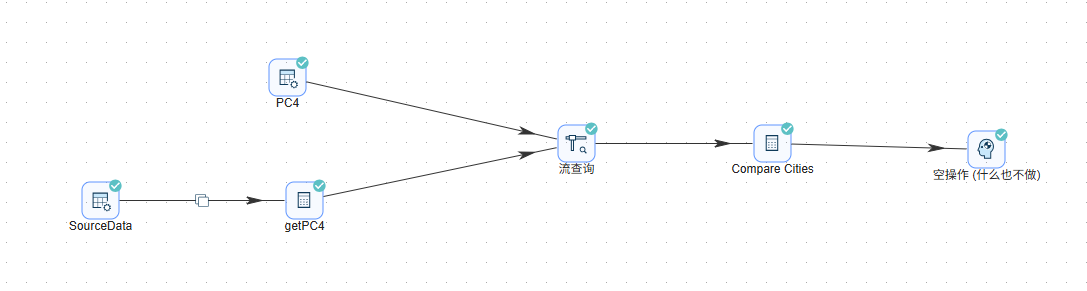
从「组件库」面板拖拽「空操作(什么也不做)」组件至画布,用于承载最终输出结果,便于预览查看。
完整转换流程图如下图所示
7. 运行转换
点击画布左上角的「运行」按钮,在弹出的提示框中点击「启动」按钮,执行整个转换流程。
运行完成后,可查看日志确认各步骤执行状态和数据条数。
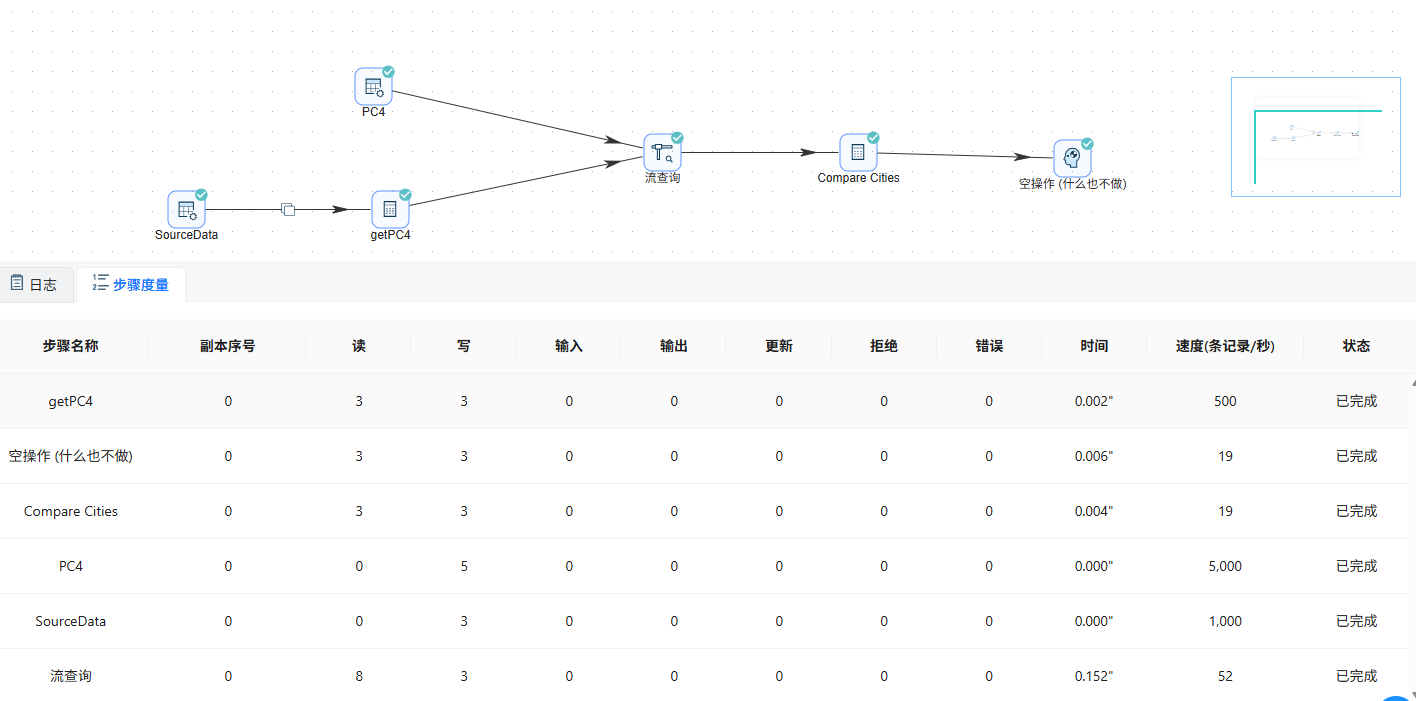
8.预览结果并分析
选中「空操作(什么也不做)」组件,右键点击「预览输出」,查看最终清洗结果。
预览数据应包含以下关键字段:
-
ID、Name、Address、PostalCode、City(原始数据) -
PC4(提取的邮编数字) -
RefCity(参照表中的标准城市名) -
cityscore(相似度评分)
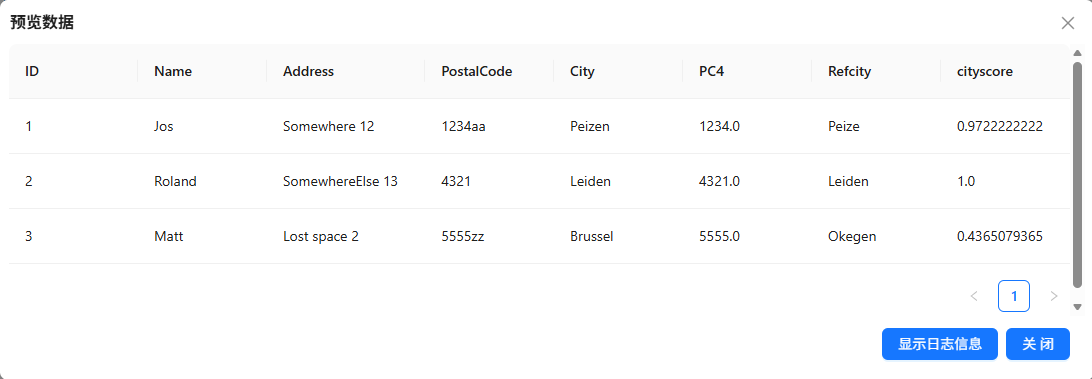
可以观察到第二条记录原始数据与参照数据的相似度非常高。
参照表清洗性别编码
有一种参照表叫数据确认主表,性别编码就是这种参照表的典型例子。在实际业务系统中,不同系统对性别的编码方式各不相同:
-
有的系统使用字母 M、F、U,分别代表男、女、未知
-
有的系统使用 Male、Female 代表男、女
-
有的系统使用 NULL 来代表未知性别
-
有的系统使用数字编码,如 0(男)、1(女) 或 0(未知)、1(男)、2(女)
-
还有更复杂的情况,如系统使用 C 代表儿童、F 代表父亲、M 代表母亲
要把这些来源各异的数据整合到一起,必须建立一套统一的编码规范,将已有的编码映射到规范的编码上。使用单一的查询表比每个系统都维护一个查询表更好,便于统一管理和维护。
这里需要满足两个基本需求:
-
源系统中的每个可能的值都需要映射(完整性)
-
所有值要映射到唯一的一组值上(一致性)
基于上述性别编码的案例,接下来将介绍如何把数据整合成统一的编码规范。
操作步骤
1.新建转换并添加 CSV 文件输入(源数据)
新建转换工作流,从「组件库」面板中拖拽「CSV 文件输入」组件至画布。
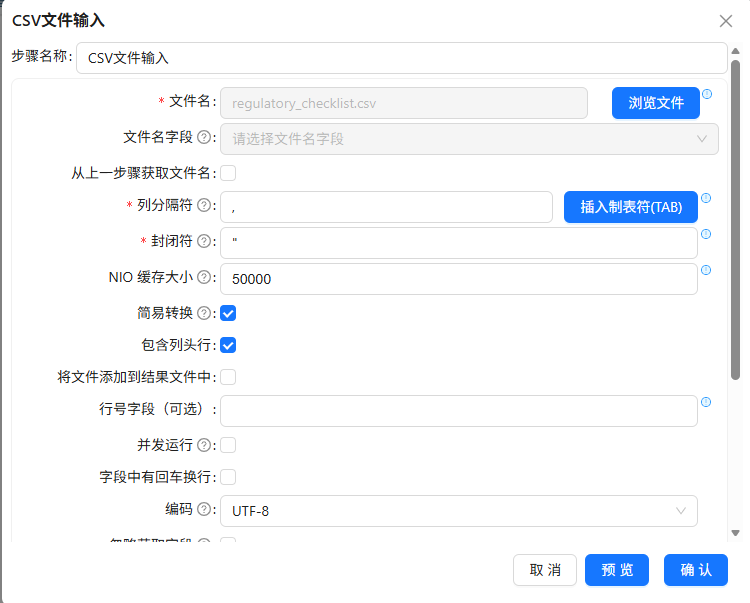
双击组件打开配置窗口,点击「浏览文件」按钮,选择 regulatory_checklist.csv 。在下方数据预览区域的空白处右键单击,选择「获取字段」,组件将自动解析并加载文件中的字段信息。
配置如下:
2.添加字段选择组件
从「组件库」面板拖拽「字段选择」组件至画布,将「CSV文件输入」组件的输出连接到「字段选择」组件。
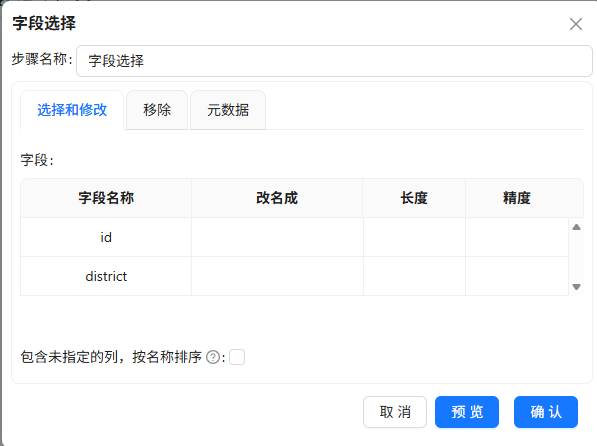
双击组件打开配置窗口,切换至「选择和修改」标签页,在空白处右键单击选择「获取选择的字段」,此时将显示上游传递过来的所有字段信息。删除不需要的字段,仅保留源编码字段 id、diatrict
3.添加第二个 CSV 文件输入(参照表)
从「组件库」面板拖拽第二个「CSV 文件输入」组件至画布,用于加载性别编码映射参照表。
双击组件,点击「浏览文件」dim_area_mapping.csv(包含异构编码与标准编码的映射关系)。提取参照表中
[ area_code ]和[ l_area_name ]数据
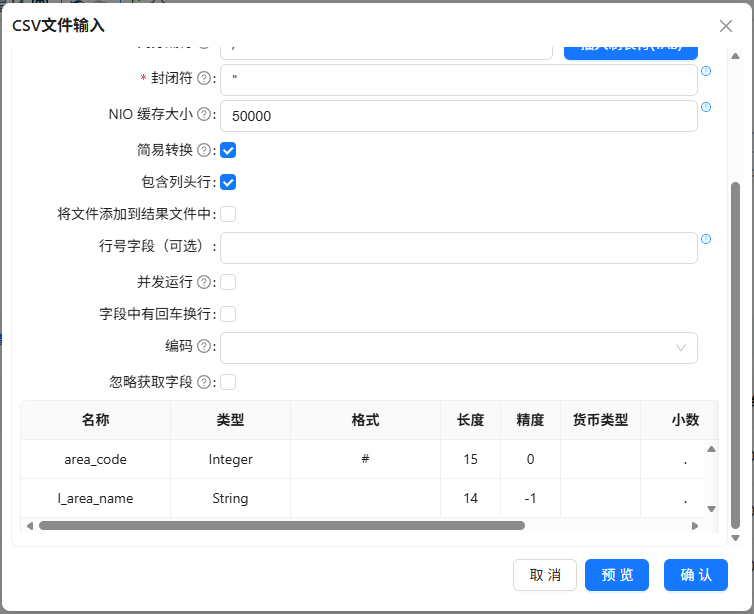
4.添加流查询组件(映射编码)
从「组件库」面板拖拽「流查询」组件至画布。将「字段选择」组件的输出连接至「流查询」组件,将参照表的「CSV文件输入」组件也连接至「流查询」组件。
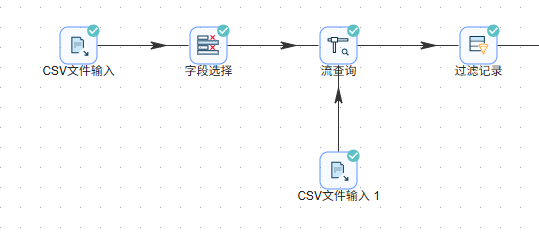
流查询步骤配置如下:
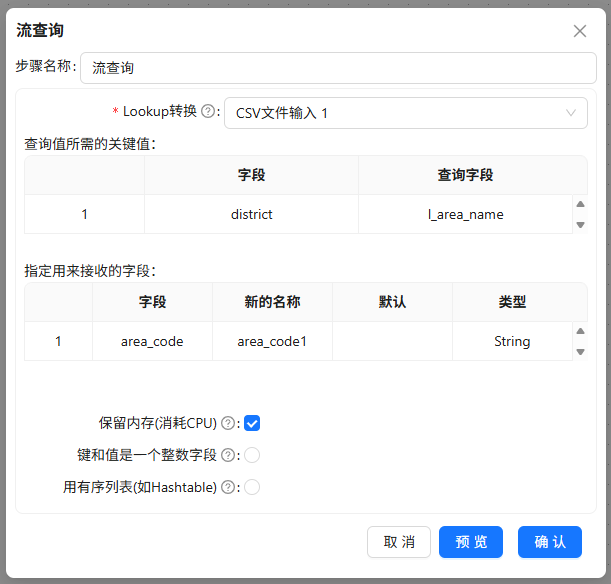
5.添加过滤记录组件(过滤未匹配数据)
从「组件库」面板拖拽「过滤记录」组件至画布,将「流查询」组件的输出连接至「过滤记录」组件。
双击组件打开配置窗口,设置过滤条件:
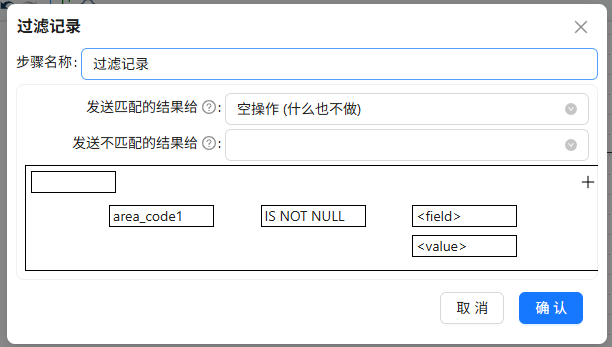
6.添加空操作组件并连接完整流程
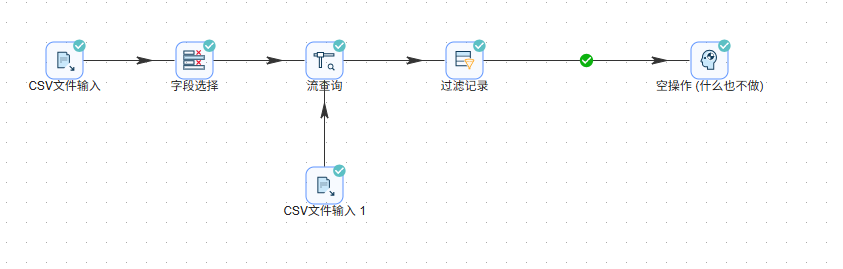
从「组件库」面板拖拽「空操作(什么也不做)」组件至画布,将「过滤记录」组件的 True 输出(有效数据)连接至「空操作」组件。若提示选择步骤,选择 True 输出。
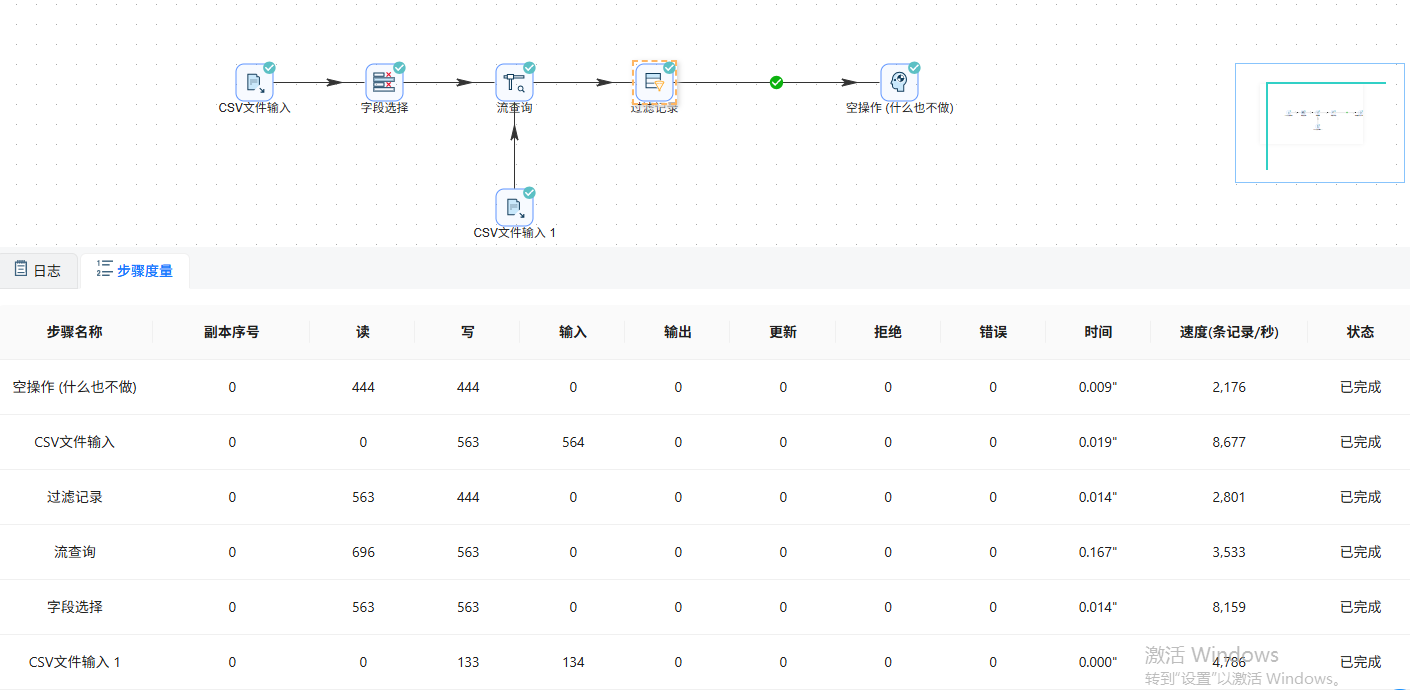
完整转换流程图如下图所示:
7.运行转换
点击画布左上角的「运行」按钮,在弹出的提示框中点击「启动」按钮,执行整个转换流程。
运行完成后,可在日志中查看各步骤执行状态: