案例说明
数据排重是一项具有挑战性的工作。许多CRM系统里的数据由客服代表录入,由于缺乏足够时间核查客户是否已在系统中存在,或录入时拼写错误,导致大量重复数据产生。这些重复记录在后续业务操作中会引发一系列问题——营销邮件重复发送、客户统计失真、资源浪费。
数据排重的核心难点在于:如何在没有可靠主键的情况下检测重复? 遗憾的是,没有任何软件能百分之百解决这类问题。但通过完全去重与模糊匹配的组合策略,可以逐步将数据整理好。
本实验将通过两个典型场景,演示如何使用助睿ETL的「去除重复记录」与「模糊匹配」组件完成数据去重任务:
-
场景一:完全重复问题——识别并移除完全相同的记录行
-
场景二:不完全重复问题——使用模糊匹配算法发现拼写错误、格式差异导致的近似重复记录
适用场景:客户数据清洗、主数据管理、营销名单去重、数据集成与迁移。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
助睿数智平台支持从数据接入、ETL处理、机器学习建模到可视化展示的全链路零代码操作,适用于高校教学与企业数据加工。本次实验使用其核心子平台——助睿ETL数据集成平台,通过数据校验组件体验零代码拖拽式数据质量管理的便捷性。
数据准备
本实验使用 customer.csv 文件,该文件存放在助睿ETL平台的「公共空间」中,使用前需先导出至个人项目空间的文件库。
| 数据文件 | 用途说明 |
|---|---|
| customer.csv | 场景一:包含客户号、地址等字段,用于完全重复记录识别 |
| customer.csv | 场景二:包含客户ID、姓氏、电子邮件等字段,用于不完全重复的模糊匹配 |
场景一:完全重复问题
完全重复是指多条记录的所有字段完全相同。这类问题相对容易处理——使用「去除重复记录」组件即可识别并移除。
提示:使用「去除重复记录」前,数据需要先按指定字段排序,否则组件无法正确判断相邻记录是否重复。
操作步骤
1.新建转换并添加 CSV 文件输入
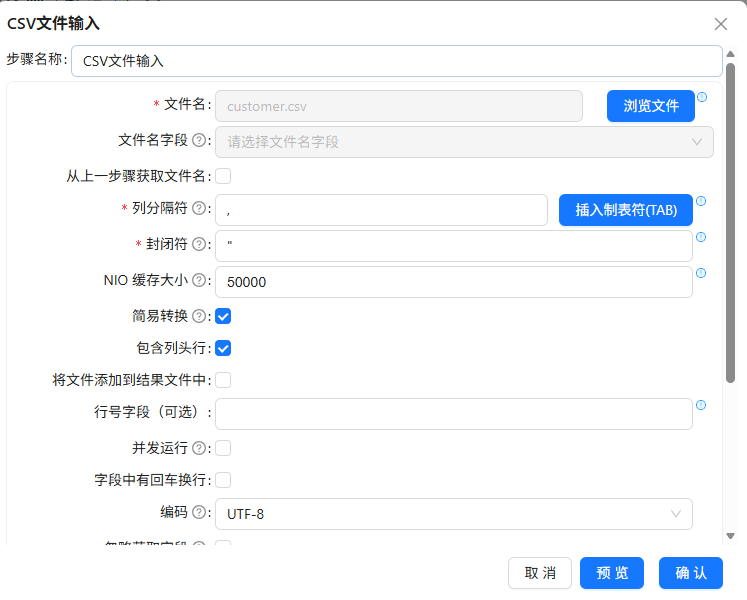
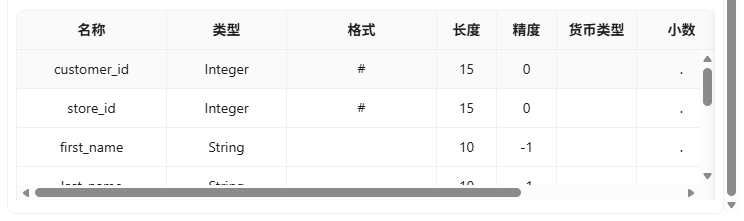
新建转换,将csv 文件输入组件拖至画布,双击组件,浏览文件选择customer.csv文件。右键空白处获取需要的客户号和地址信息并按照地址号排序,配置如下图所示:
2.添加去除重复记录组件
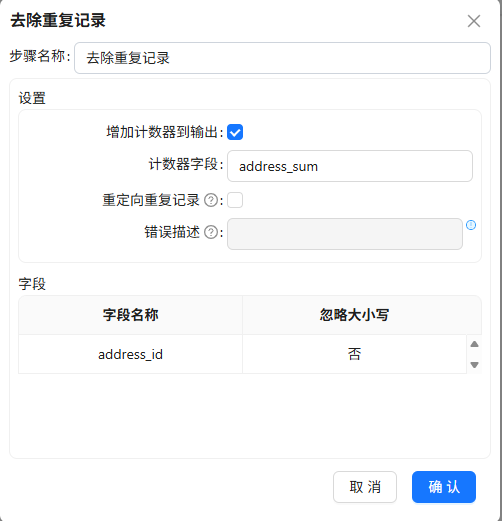
CSV输入组件连接到去除重复记录组件,双击重复记录组件进行如下配置:
3.添加空操作组件并运行
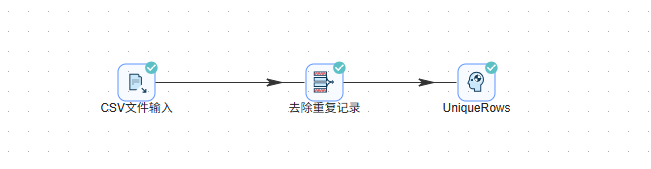
添加空操作组件,双击进行配置,命名为 UniqueRows,连接去除重复记录组件的输出。
完整流程图如下
4.点击「运行」按钮执行转换。
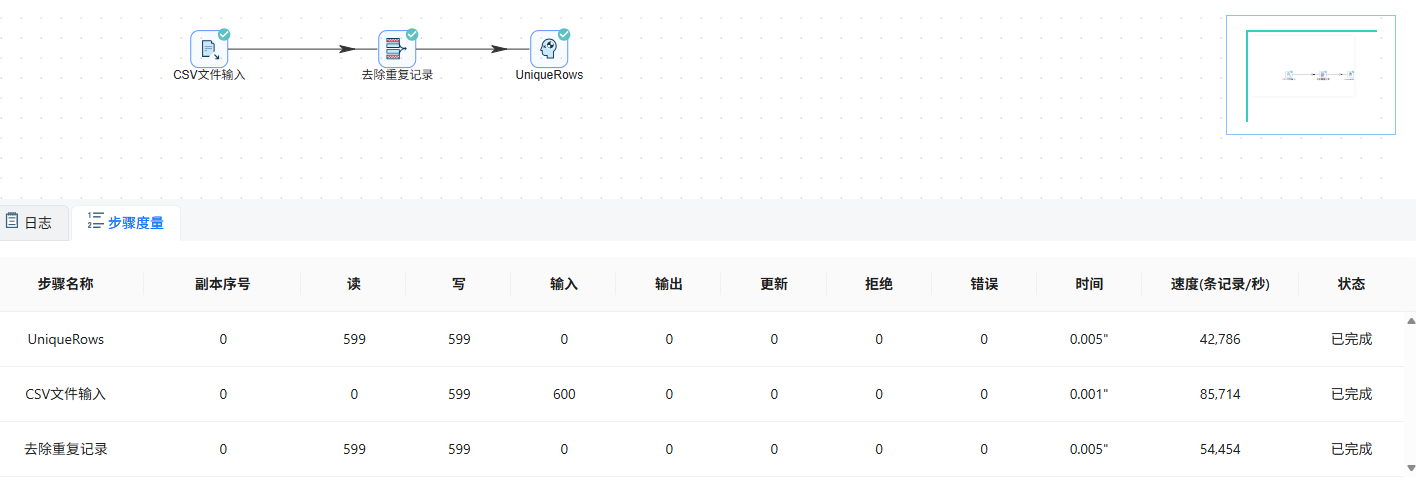
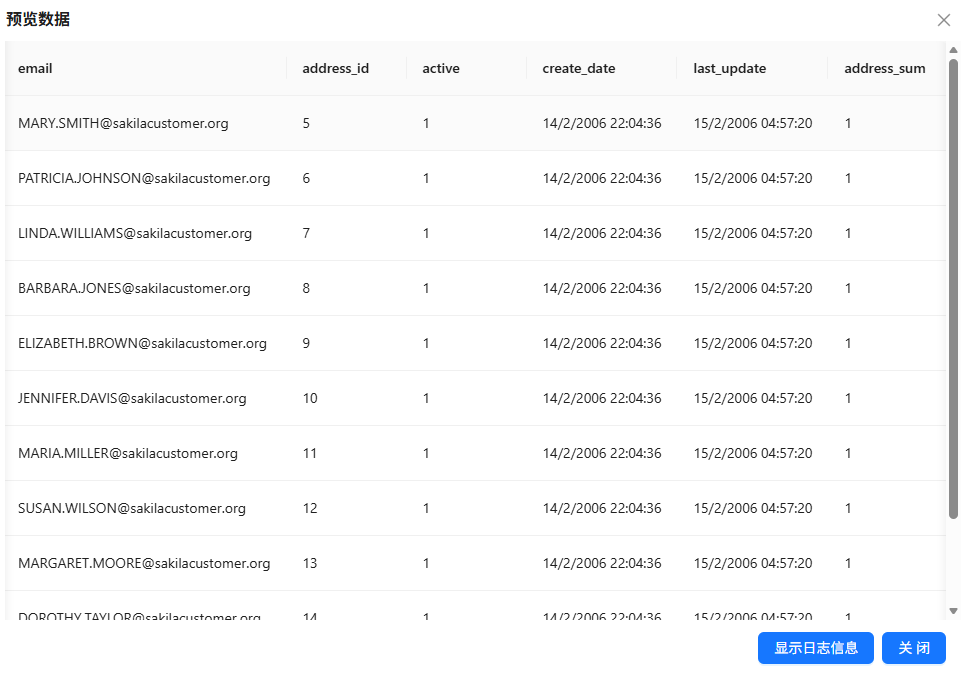
运行完成后,选中 UniqueRows 组件,右键选择「预览输出」查看结果。
【address_sum】字段显示【address_id】字段出现的次数,此处数据的重复率并不高,但当数据拥有很多重复信息时,计数器将起到重要的作用。结果如下图所示:
场景二:不完全重复问题
1.新建转换并添加“CSV文件输入”和“字段选择”组件
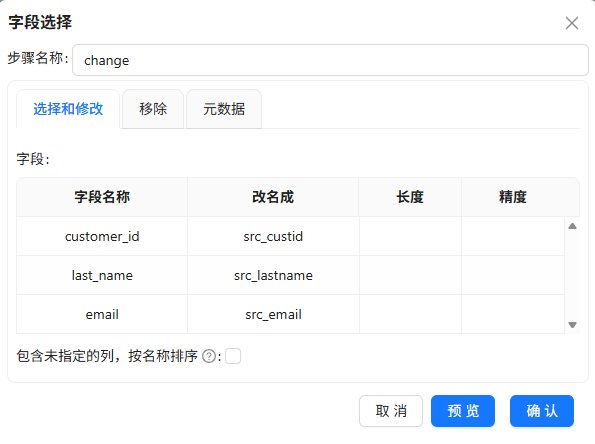
新建转换工作流,从组件库板拖拽两个「CSV文件输入」组件和两个 [字段选择] 组件至画布。分别把csv组件和字段选择组件两两一组进行连接,并且分别命名csv,字段选择,csv1,字段选择1为ReadSource,change,Lkp_LastName,change1。分别配置如下:
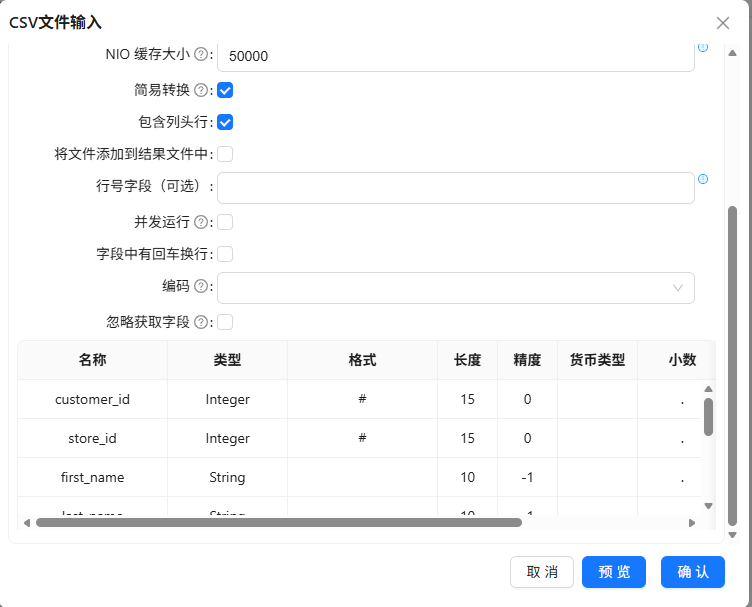
CSV配置:
浏览文件选择customer.csv文件,列分隔符填“;”,封闭符填“ " ”,单击空白处获取客户号、客户姓氏和邮件字段,
字段选择配置:
CSV1配置:
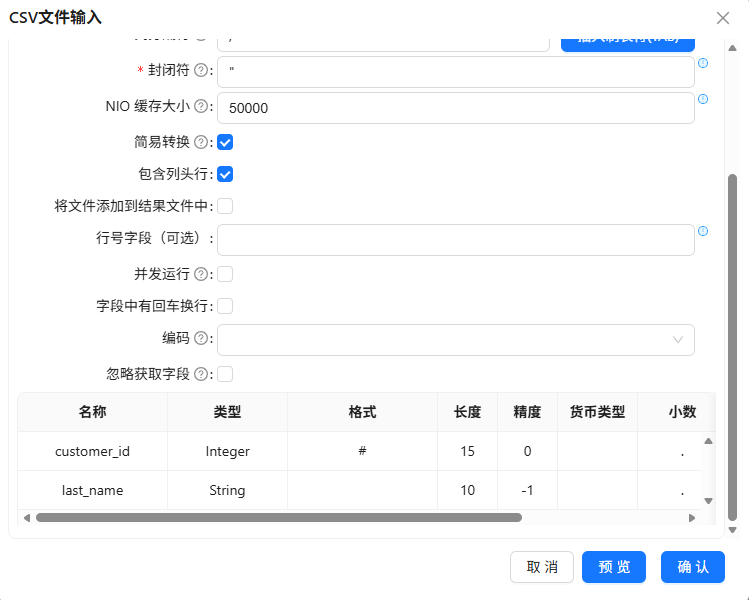
字段选择1配置:
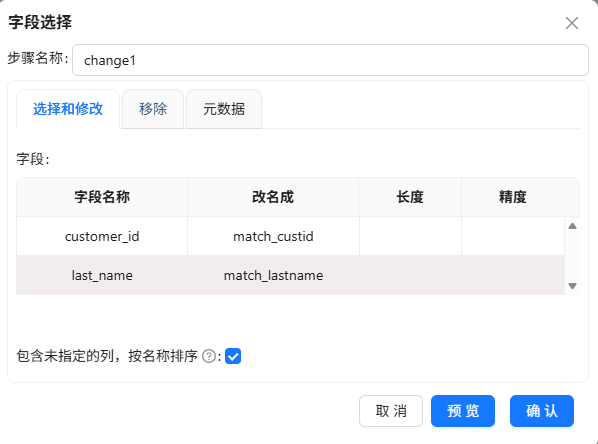
2.添加模糊匹配组件
拖拽「模糊匹配」组件至画布,步骤名称命名为MatchLastName,将 change 和 change1 两个步骤的输出同时连接至模糊匹配组件。双击配置:
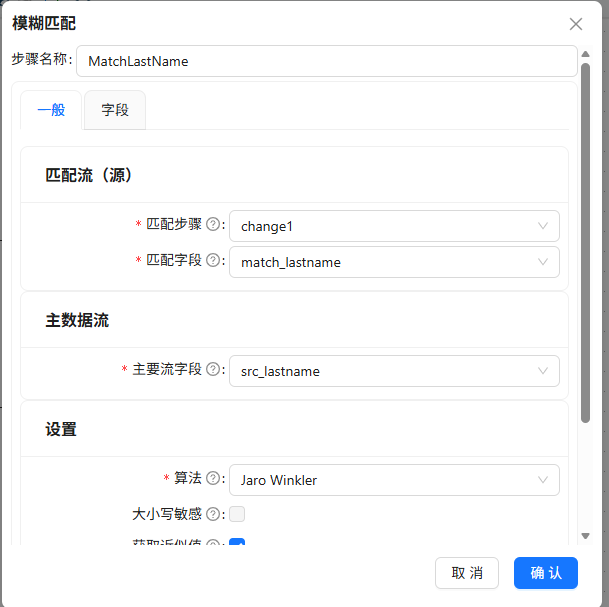
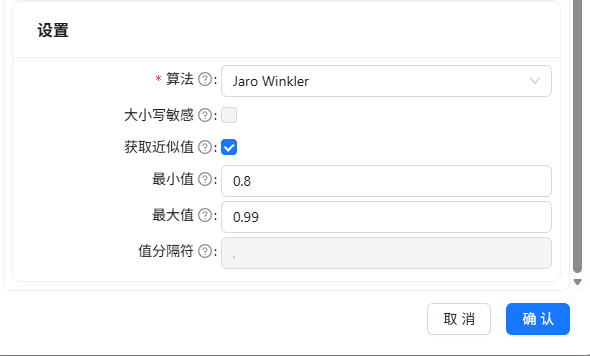
算法选择说明:
Jaro-Winkler:对拼写错误容忍度高,适合姓名匹配
Levenshtein:计算编辑距离,可设置区分大小写
Soundex/Metaphone:基于发音的匹配,适合英文姓名「获取近似值」选项说明:勾选后只返回相似度最高的匹配结果;不勾选则返回相似度在最小值和最大值之间的所有匹配值(多个值用分隔符分开),对排重场景帮助有限。
切换到字段页面,配置如下:
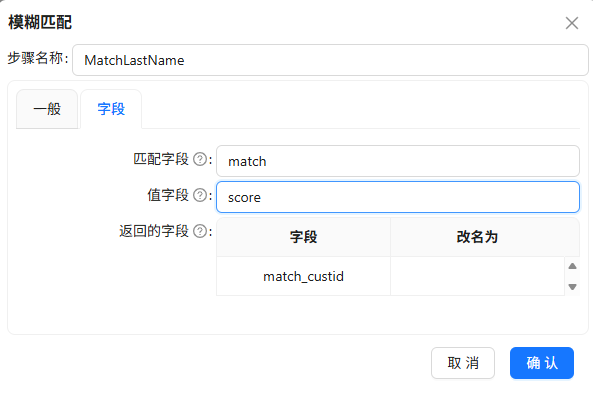
3.添加过滤记录组件
拖拽「过滤记录」组件,连接模糊匹配的输出。此步骤筛选出存在姓氏近似匹配的记录,交由后续电子邮箱校验进一步确认是否为同一人。未匹配的记录可视为安全数据。配置过滤条件:
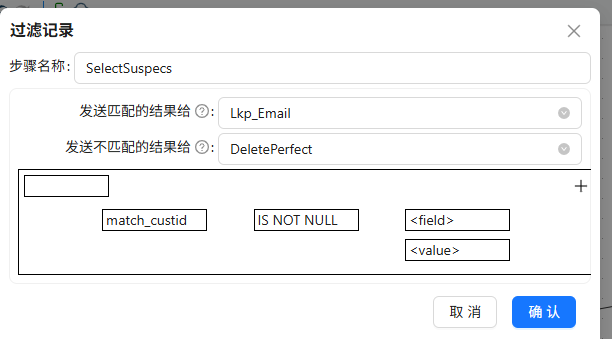
4.添加数据库查询与二次过滤
为更精确地识别重复,引入电子邮箱作为辅助校验字段:
该组件需要两个输入源:
-
主输入流:来自过滤记录组件
SelectSuspects输出的疑似重复数据 -
查询输入流:来自另一个「CSV文件输入」组件提供的电子邮箱参照数据
说明:电子邮箱是相对稳定的个人标识。如果姓氏相近且邮箱完全一致,基本可判定为同一人。此步骤作为二次确认,有效提高排重准确率。
- 拖拽「数据库查询」组件或「流查询」,这里我们使用流查询组件作为例子,步骤名称命名为
Lkp_Email,配置按电子邮件查询
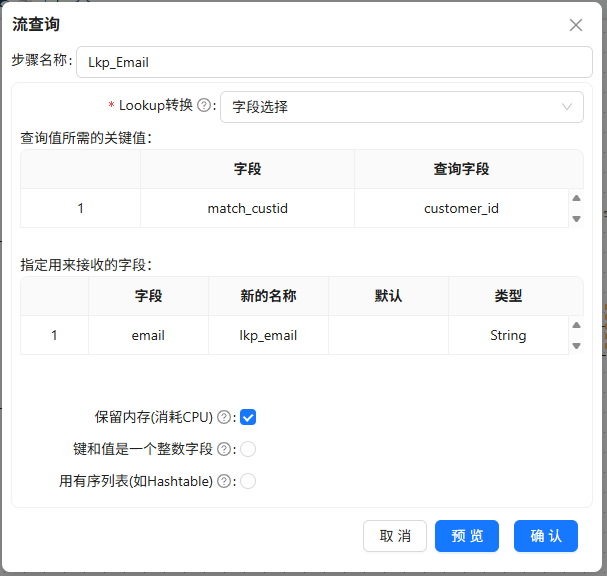
将csv 文件输入和字段选择组件拖至画布,csv文件输入连接到字段选择后,字段选择接入流查询组件
配置步骤:
先拖拽一个新的「CSV文件输入」组件至画布,用于读取包含电子邮箱的参照数据。双击组件,浏览customer.csv文件,在数据预览区右键「获取字段」完成字段解析,点击「确认」保存。
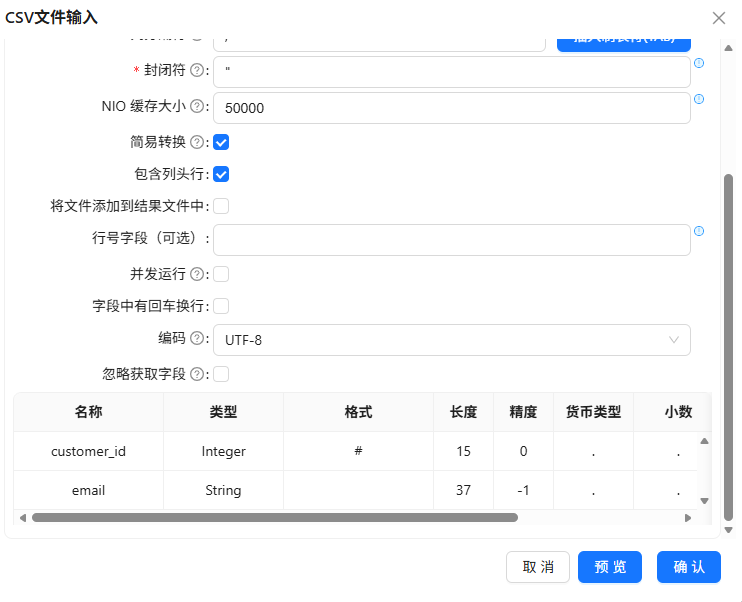
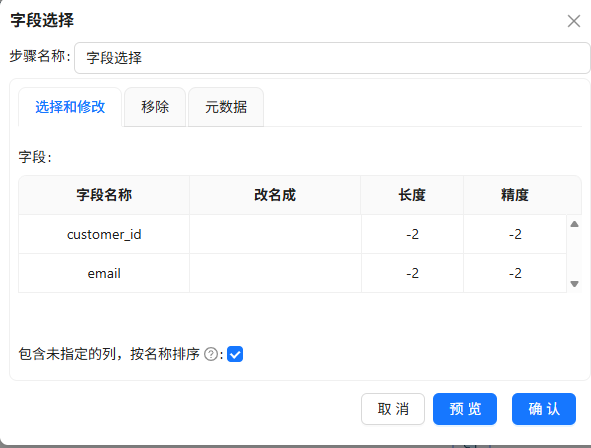
② 拖拽「字段选择」组件至画布,连接上一步csv输入 组件,双击组件。点击「获取选择的字段」加载所有字段,仅保留 e-mail 字段(或同时保留客户ID便于后续关联),点击「确认」保存。
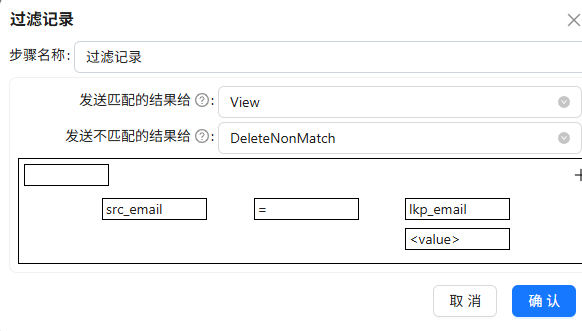
5.再次添加「过滤记录」组件,筛选邮件匹配的记录
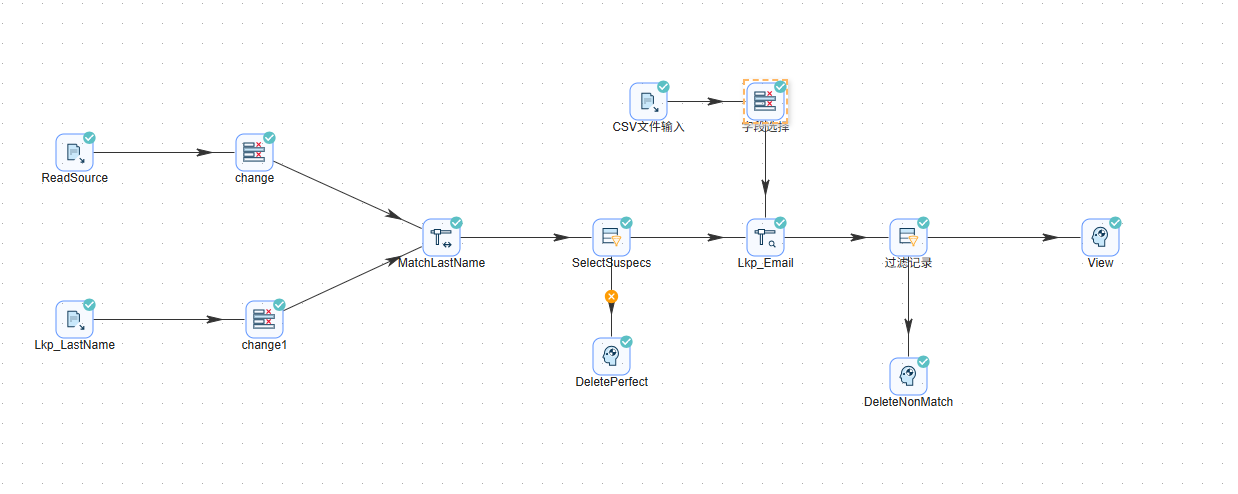
6.添加空操作组件并连接完整流程
拖拽三个「空操作(什么也不做)」组件至画布,分别命名为:
-
DeletePerfect:连接第一个过滤记录的 False 输出(无姓氏匹配) -
DeleteNonMatch:连接第二个过滤记录的 False 输出(姓氏相近但邮箱不同) -
View:连接第二个过滤记录的 True 输出(姓氏相近且邮箱一致)
按顺序连接各组件,若提示选择步骤,根据上述说明选择对应的输出分支。
完整流程图如下:
7.运行转换并预览结果
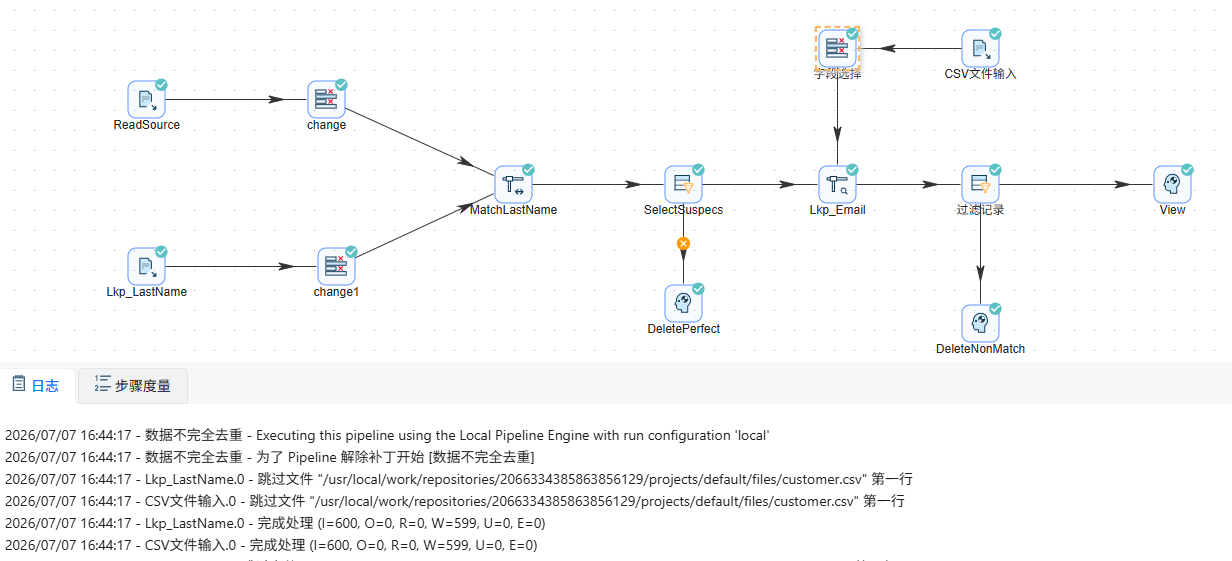
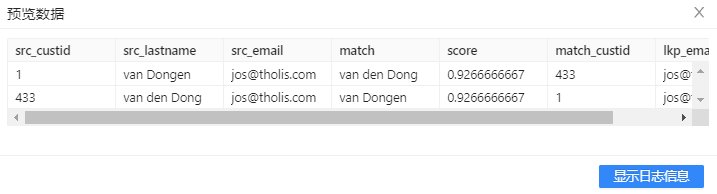
- View 分支:姓氏相近且邮箱完全相同的数据 → 高度疑似重复,建议合并
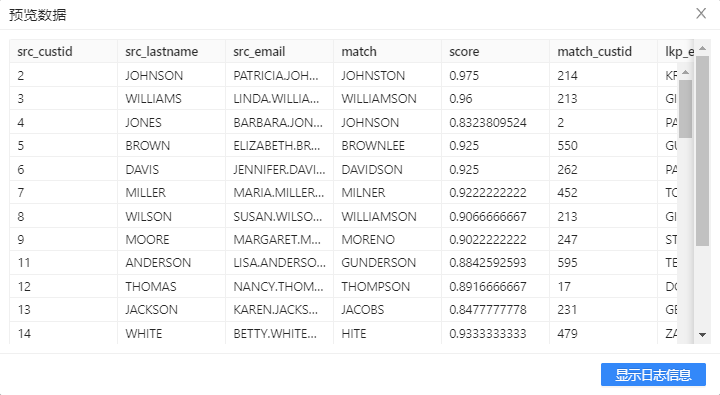
- DeleteNonMatch 分支:姓氏相近但邮箱不同的数据 → 待人工审核,可能是不同的人(如父子、夫妻共享姓氏)
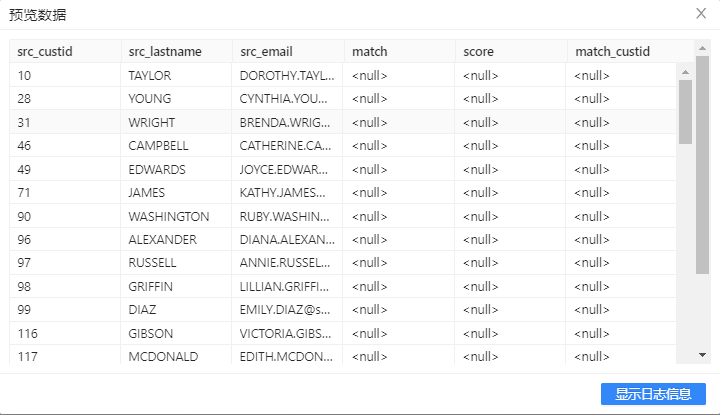
- DeletePerfect 分支:无姓氏匹配的数据 → 确认不重复,安全保留
排重工作的注意事项
正确性问题:即使找到了不同地址或不同电话号码的重复记录,仍需谨慎判断哪个地址或电话号码是正确的。并非所有业务系统都保留详细的变更日志,即使有日志,也存在人为错误的可能。
合并策略建议:
-
确定以哪条记录的数据为准(如最后更新时间、数据来源优先级)
-
地址应作为整体处理,拆分后单独合并可能产生无意义的结果
-
实际应用场景中,排重后建议设置人工审核环节,避免误合并