案例说明
在处理真实的数据集时,数据往往并不是完美无瑕的,其中会夹杂着一些"脏"数据。在数据处理的过程中,不能一味地把错误的数据丢弃,必须制定完善的错误处理步骤来处理那些"脏"数据。本实验主要展示错误数据的处理,通过错误捕获机制为异常字段赋予合理的默认值,确保ETL流程的健壮性和数据完整性。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
助睿数智(Uniplore)是AI驱动的一站式数据科学平台,覆盖从数据接入、ETL处理、机器学习建模到可视化展示的全链路零代码功能,为用户提供高效、灵活的数据处理体验。本次实验基于其核心子平台——助睿ETL数据集集成平台,以拖拽式组件编排的方式,直观体验数据校验任务的构建与执行过程。
数据准备
本实验使用 project.txt 文件,请提前从平台「公共空间」获取并上传至个人文件库。
该文件包含了项目估算数据,其中 estimated 字段在正常情况下应为数值类型,但第6行数据中包含非数字字符(脏数据),将在后续类型转换时触发错误。
注意:文件以分号(;)作为列分隔符,首行为列头。
操作前请确保已登录助睿ETL平台,并可正常访问文件库与组件库。
为什么需要为脏数据设置默认值
在真实业务场景中,数据往往来自不同的采集渠道:用户手工录入、第三方系统导入、历史数据迁移等。不同来源的数据质量参差不齐,缺失值、格式错误、异常值等问题不可避免。
如果在ETL过程中直接丢弃异常数据,会带来两方面的问题:一是信息损失——该条记录的其他字段可能包含重要信息;二是流程中断——某些ETL工具在遇到异常时会停止执行,影响整体数据处理进度。
因此,更合理的做法是将异常数据纳入独立的错误处理流程,为其设置合理的默认值,既保证流水线不中断,又为后续的数据分析保留了完整的记录。例如,将缺失的估算值设为行业平均值或历史中位数,既能填补空缺又不会对分析结果造成过大偏差。
本小节将演示:通过字段选择步骤将 estimated 字段的类型从 String 转为 Integer,当第6行的脏数据触发类型转换错误时,错误数据通过错误输出分支流向写日志组件记录错误信息,同时经增加常量组件为 estimated 字段赋予默认值180,最终与正常数据汇合后继续向下游传递。
操作步骤
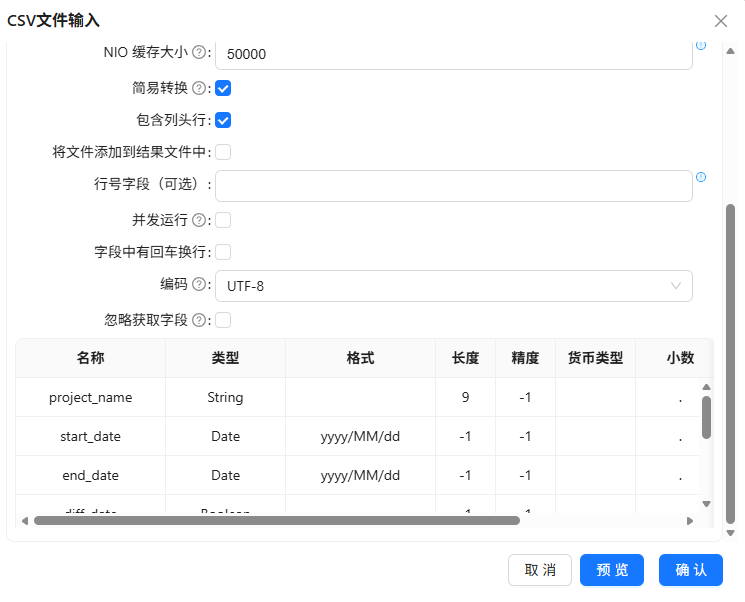
拖拽「CSV文件输入」组件至画布。双击组件,点击「浏览文件」选择 project.txt,设置列分隔符为 ;,勾选「包含列头行」,在数据预览区域右键选择「获取字段」完成字段解析。
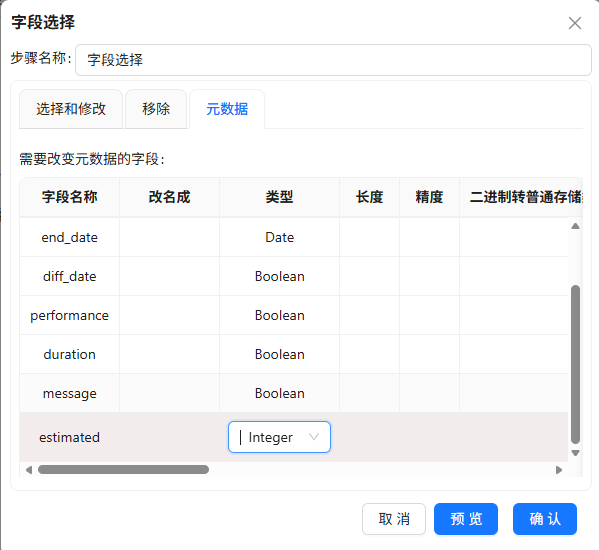
拖拽「字段选择」组件至画布,连接CSV文件输入组件(选择主输出步骤)。双击组件,切换至「元数据」标签页,右键「获取字段」加载所有字段,将 estimated 字段的类型从 String 修改为 Integer。
此处故意将字符串字段转为整数类型,当遇到非数字内容时便会触发类型转换错误,错误数据会通过组件的错误输出分支流出,从而实现正常数据与异常数据的分离。
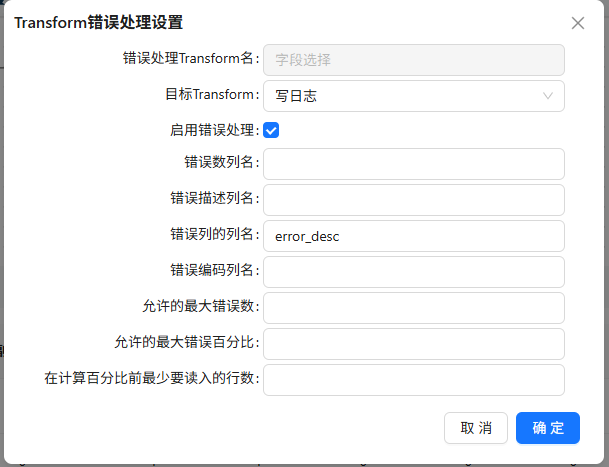
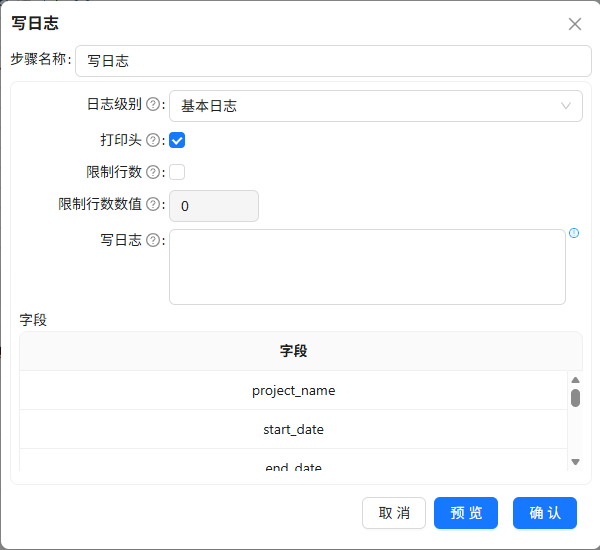
拖拽「写日志」组件至画布,建立从「字段选择」到「写日志」的错误输出步骤连接。
双击连线上的错误图标,在「错误描述列名」中输入 error_desc,该字段将记录具体错误信息,便于后续追溯哪些记录因何原因触发错误,为数据质量分析提供依据。
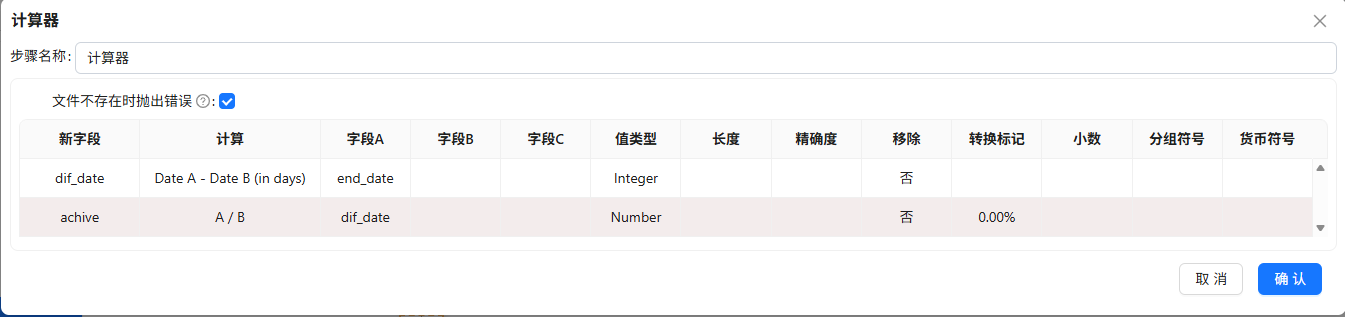
拖拽「计算器」组件至画布,连接「字段选择」组件的主输出步骤。通过类型校验的正常数据将进入此分支进行后续处理。配置如下:
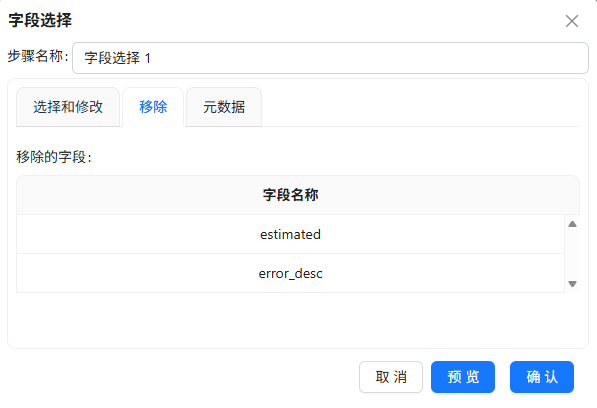
拖拽第二个「字段选择」组件至画布,连接至「写日志」组件(主输出步骤),用于配置错误数据输出时的字段结构,确保与后续组件对接无误。
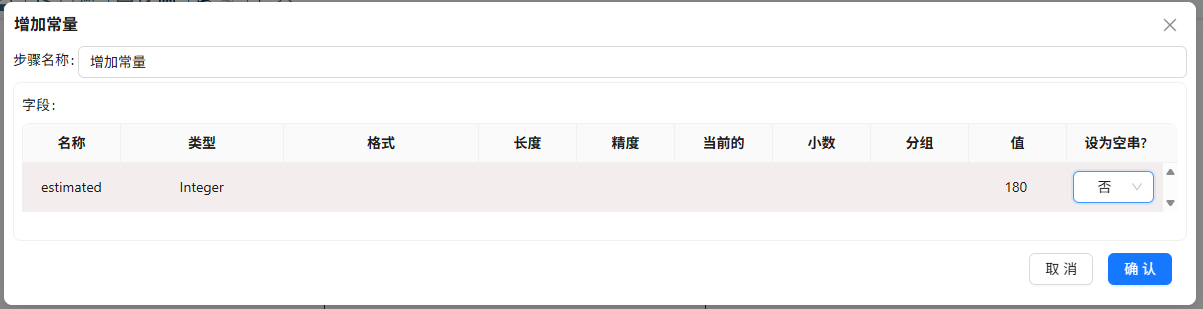
拖拽「增加常量」组件至画布。依次建立连接:从「字段选择」连接到「增加常量」,再从「增加常量」连接到「计算器」组件。
此时,正常数据流和错误处理流在「计算器」处汇合——正常数据保留原始 estimated 值,错误数据则被赋予默认值180。这样即使部分数据存在质量问题,整体流程仍能继续执行。
双击「增加常量」组件,配置新增字段:字段名 estimated,类型 Integer,值 180。
点击画布左上角的「运行」按钮,在弹出的提示框中点击「启动」执行转换。
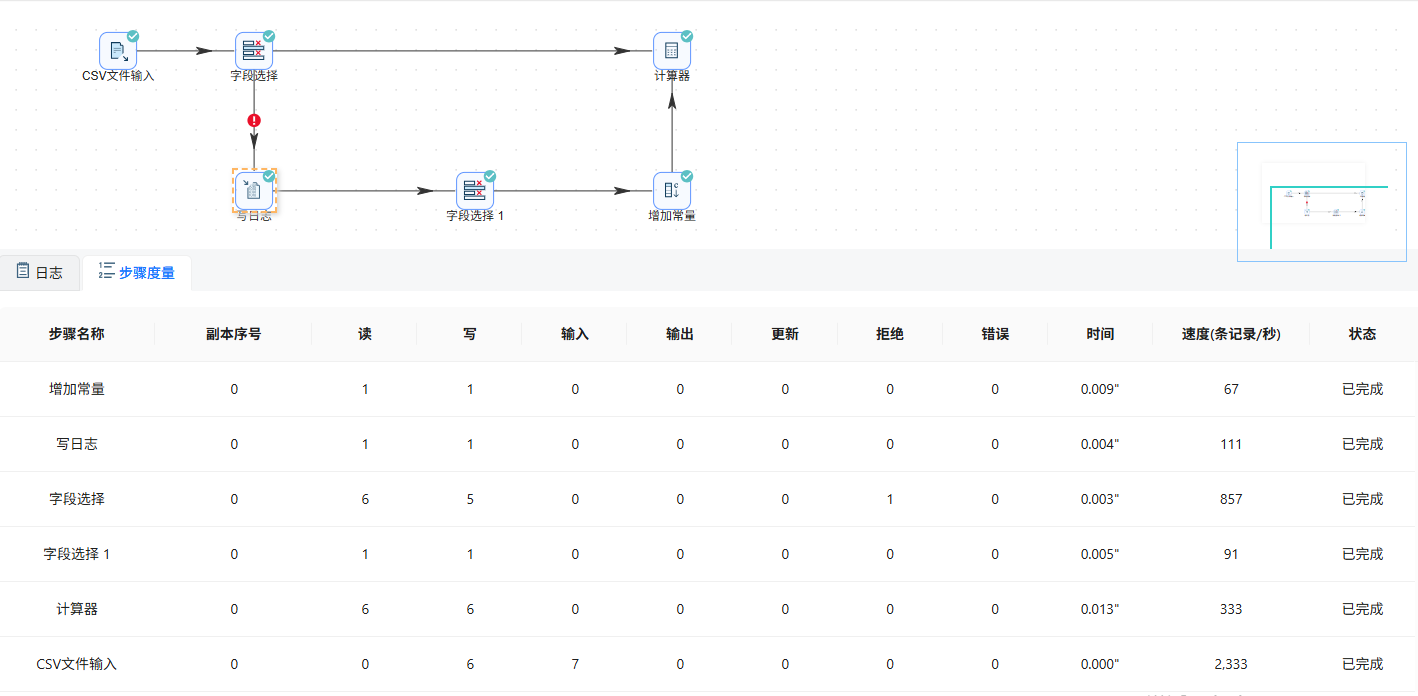
运行完成后查看执行日志,原始数据中第6行(estimated 包含非数字字符)在字段选择组件中被捕获并送入错误分支,经「增加常量」赋予默认值180后,与其他正常数据一同输出至计算器组件,实现了"脏数据不丢弃、流程不中断"的目标。
总结
本实验演示了助睿ETL中脏数据处理的核心机制——错误捕获与默认值替换:
-
错误输出分支:助睿ETL组件的错误输出分支可将异常数据从正常数据流中分离,避免流程因单条数据错误而整体中断。
-
默认值策略:通过「增加常量」组件为异常字段设置合理的默认值,既保证了数据的完整性,又避免了空值或异常值对下游分析的影响。
-
数据流汇合:正常数据流与错误处理流最终汇合的设计模式,保证了所有数据都能被妥善处理,是工业级ETL流程的常用实践。