案例说明
数据流是ETL过程中的核心概念,指数据在转换步骤之间有序流动的序列。在实际数据处理中,数据流并非一成不变的单一路径——可能需要将同一份数据同时输出到多个目标,也可能需要根据数据内容决定其流向,还可能面临多源数据合并以及异常数据的容错处理等场景。能否灵活控制数据流,直接影响ETL流程的可维护性与扩展性。
本实验将系统性地展示助睿ETL平台中五种典型的数据流控制方式:复制分发、随机分发、条件路由、多流合并以及错误分流,帮助掌握构建复杂ETL流程的核心方法。
适用场景:多路数据输出、条件分支路由、多源数据合并、脏数据处理。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
数据准备
本实验使用以下数据文件,可从平台「公共空间」获取,也可直接下载下方链接后上传至项目文件库:
| 数据文件 | 用途说明 |
|---|---|
| Pentaho+BI+Platform+Tracking.xls | 控制数据流、数据分发、Switch/Case小节 |
| progress_b_bouchard.xls | 合并数据小节(数据源一) |
| progress_other_programmers.xls | 合并数据小节(数据源二) |
Pentaho+BI+Platform+Tracking.xls
progress_other_programmers.xls
注意:所有Excel文件均使用 Excel XLSX 引擎读取,首行为列头。
控制数据流
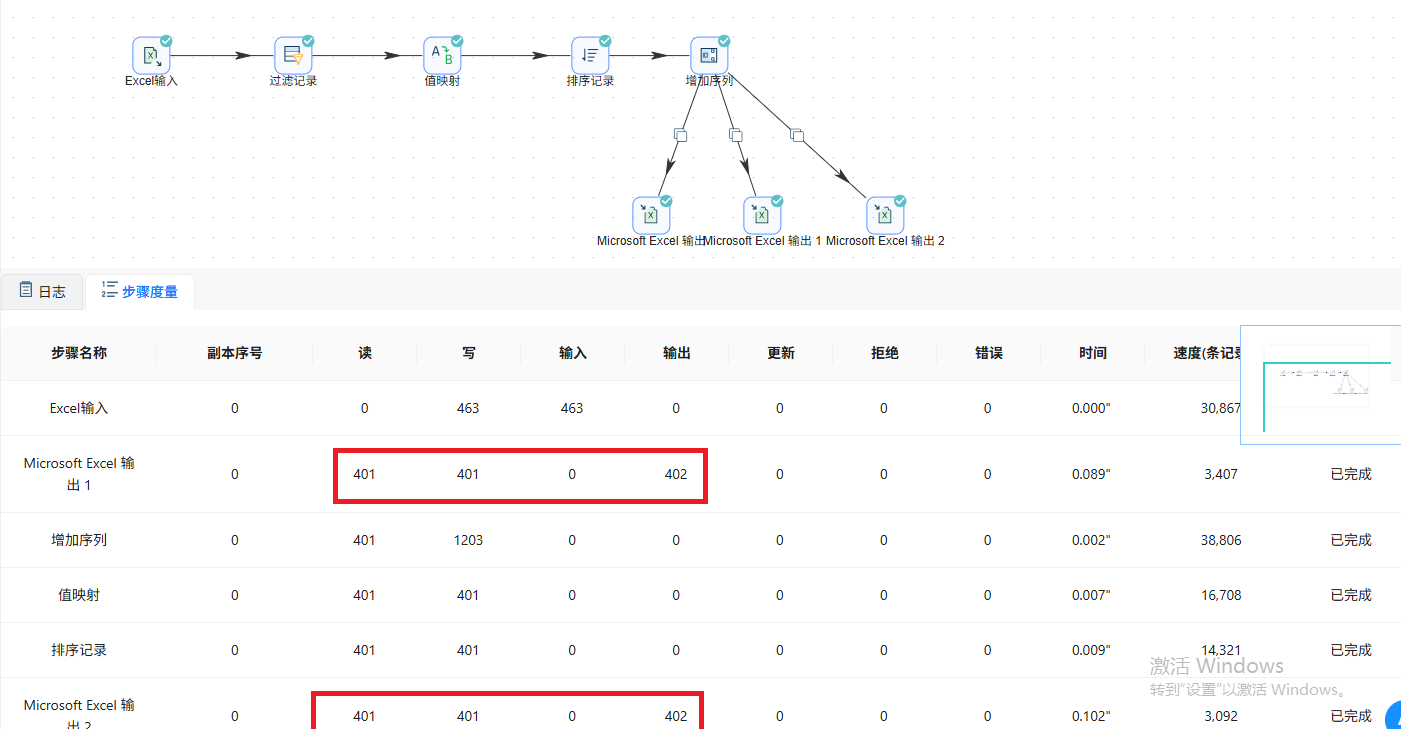
本小节将演示数据流的基本控制方式:数据从Excel输入组件读取后,依次通过「过滤记录」筛选有效数据、「值映射」转换字段含义、「增加序列」生成行号,最后将处理完成的完整数据集复制发送至三个Excel输出组件。
这里的关键是"复制发送"模式——三个输出组件接收到的数据完全一致,适用于需要将同一份处理结果同时归档到不同位置、或同时供多个下游系统使用的场景。例如,一份数据同时写入生产数据库、备份库和数据分析库时,无需重复执行三次相同的转换流程,只需一次处理、多路分发即可。
操作步骤
- 添加并配置Excel输入组件
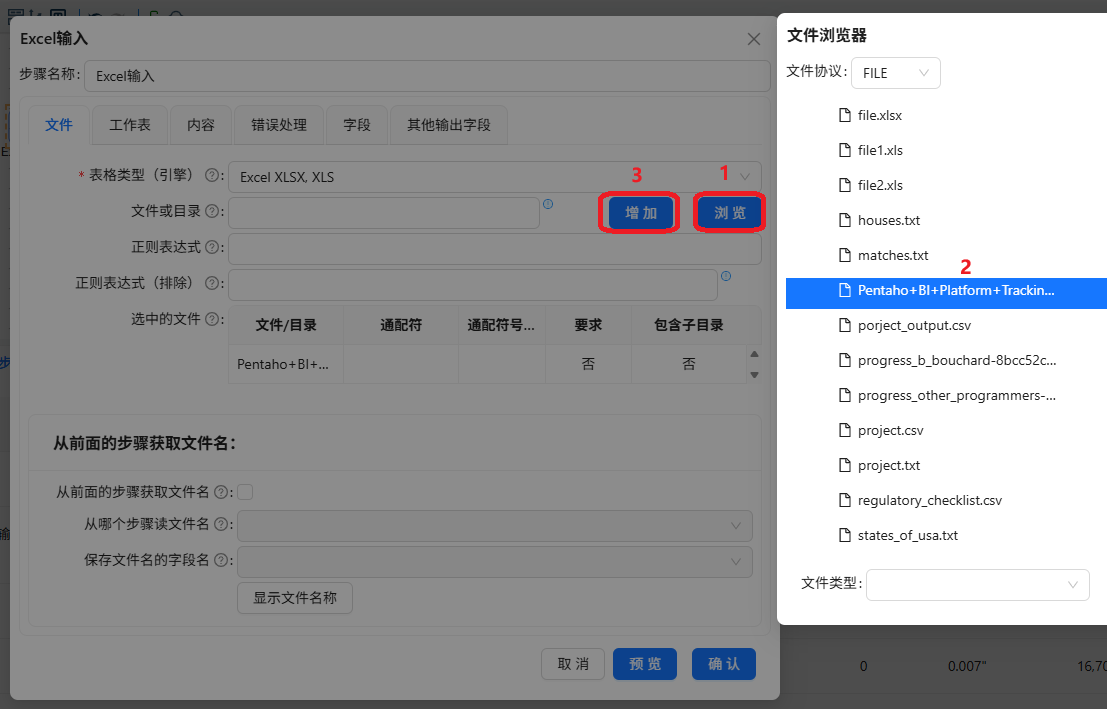
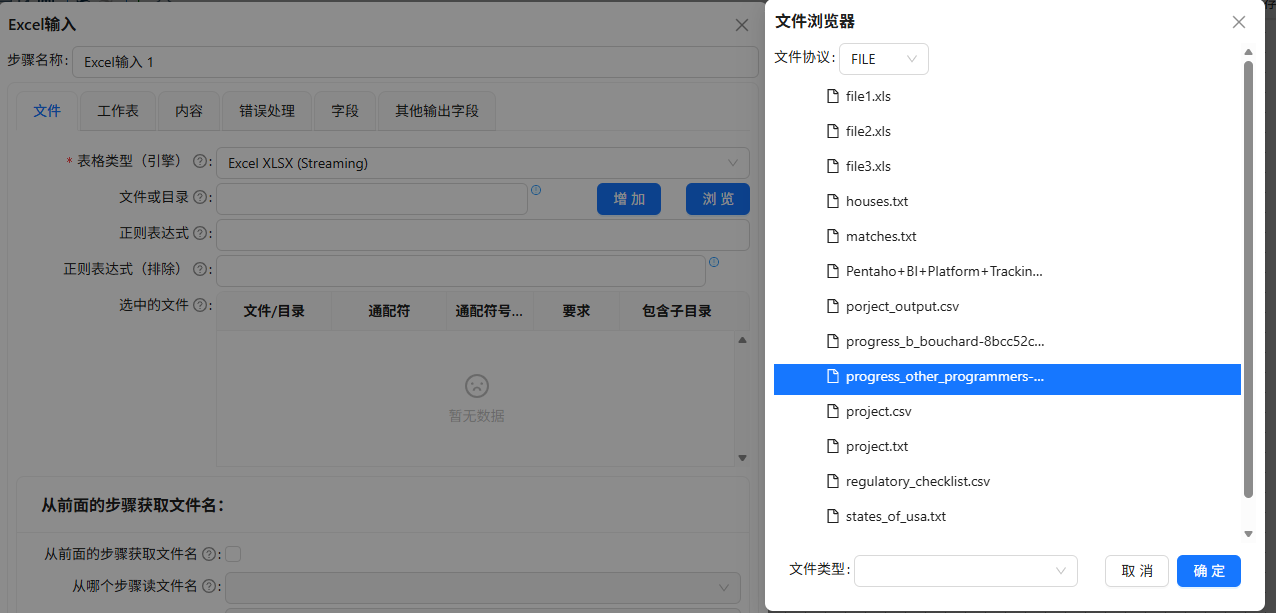
拖拽「Excel输入」组件至画布。双击组件,在「文件」页签中选择表格类型为 Excel XLSX,XLS,点击「浏览」选择 Pentaho+BI+Platform+Tracking.xls,点击「增加」将文件添加至选中列表。
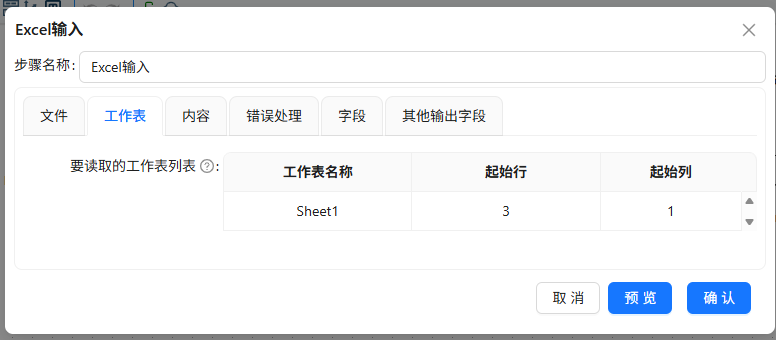
切换至「工作表」页签,右键点击「获取工作表名称」获取工作表列表。设置起始行为 3,起始列为 1,跳过文件头部的非数据行。
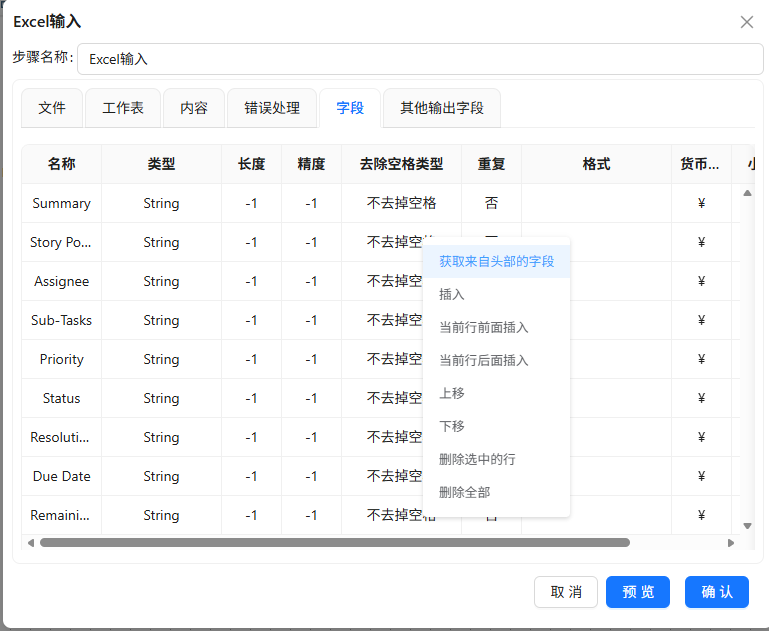
切换至「字段」页签,右键选择「获取来自头部的字段」,自动解析字段结构。
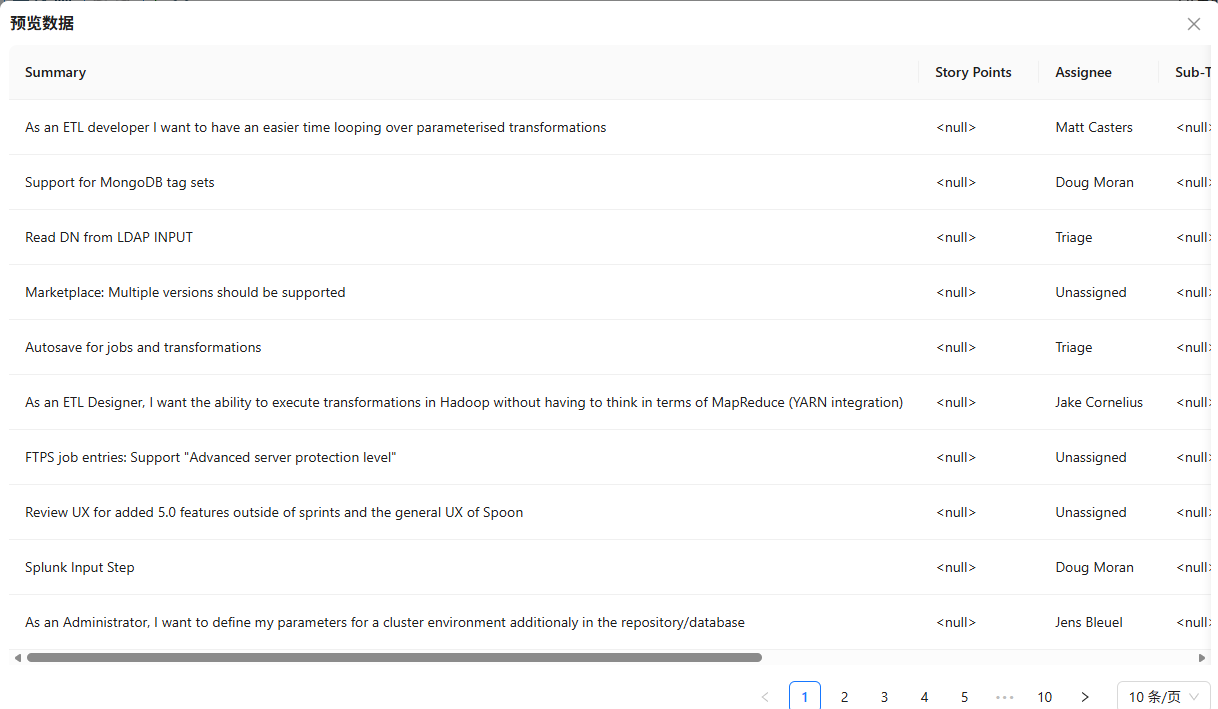
选中Excel输入组件,右键「预览输出」查看数据读取结果。
- 添加过滤记录组件
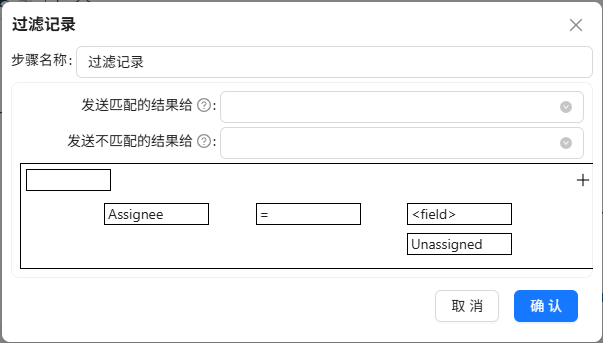
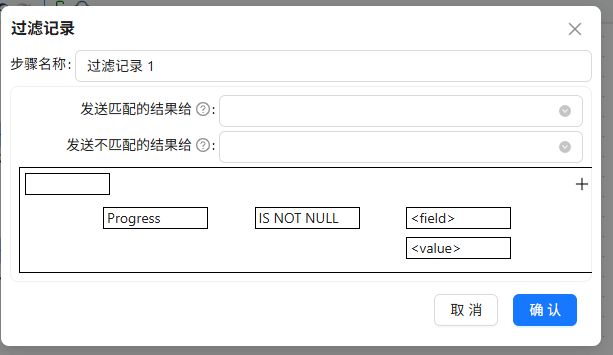
拖拽「过滤记录」组件至画布,连接Excel输入组件。配置过滤条件(如 Progress 字段不为空),过滤掉无效记录。
- 添加值映射组件
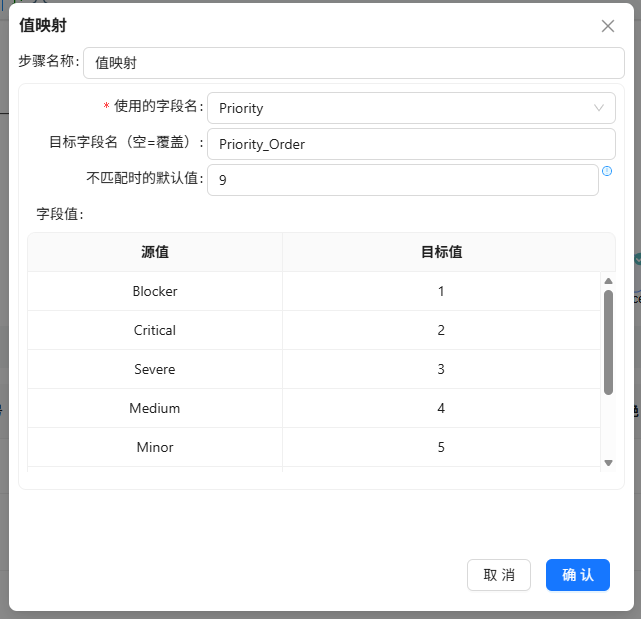
拖拽「值映射」组件至画布,连接过滤记录组件。配置需要映射的字段及映射规则,将源字段值映射为目标值。
- 添加排序记录组件
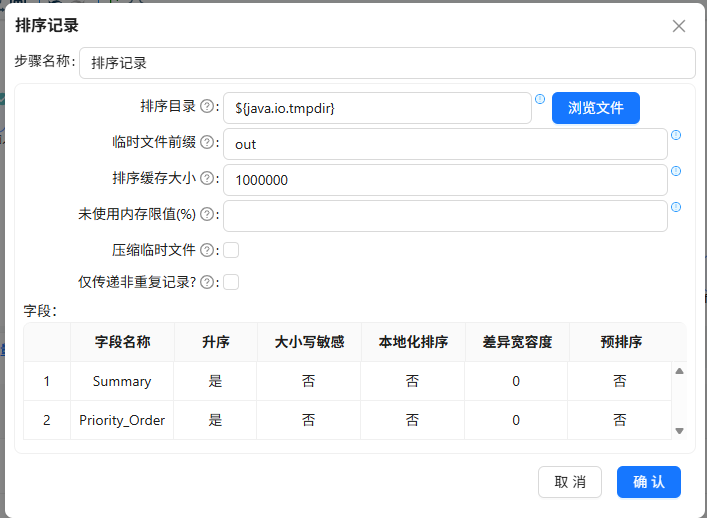
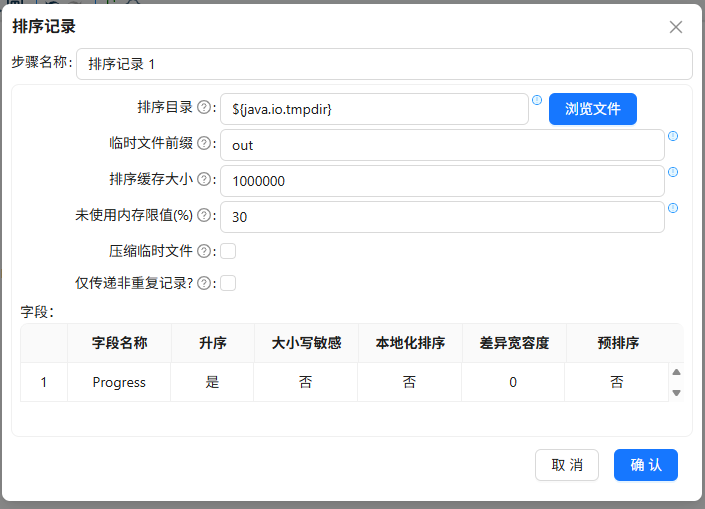
拖拽「排序记录」组件至画布,连接值映射组件,按指定字段排序。
- 添加增加序列组件
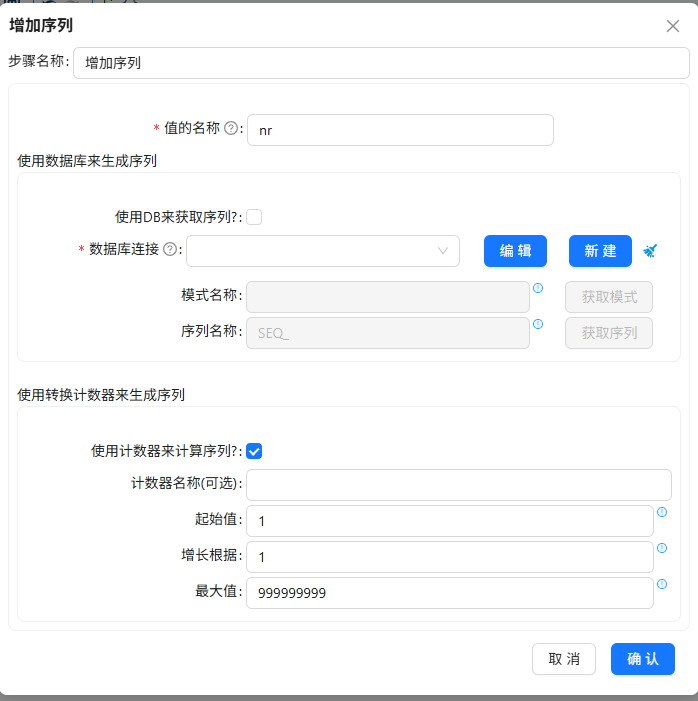
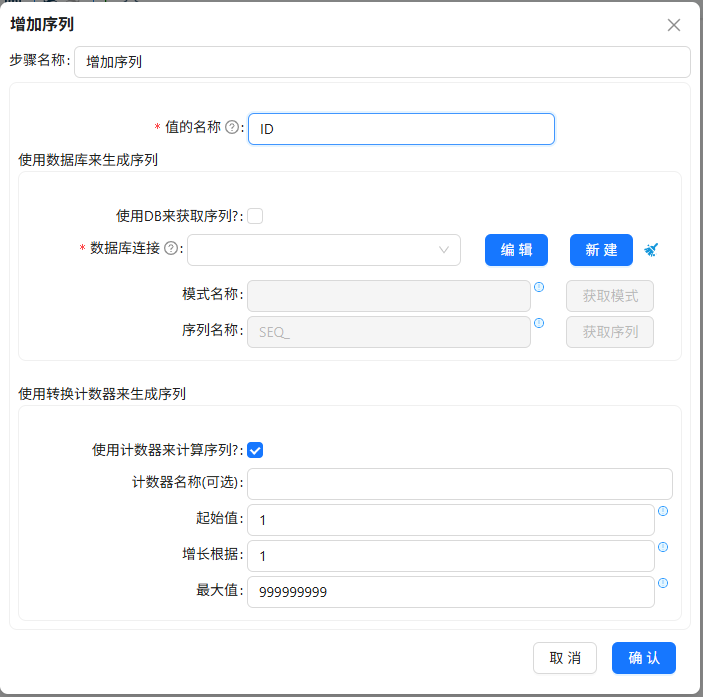
拖拽「增加序列」组件至画布,连接排序记录组件,该组件为每条记录生成一个递增序号作为新字段。这个序号在实际应用中价值明显——可作为数据的行标识、用于分页展示,或与外部系统对接时作为批次号使用。
- 添加三个Excel输出组件
拖拽三个「Excel输出」组件至画布,分别与增加序列组件建立连接,连接方式选择复制发送,配置组件时文件名分别命名为file,file1,file2实现数据复制分发。
- 运行转换
点击「运行」执行转换,查看执行日志。
- 预览结果
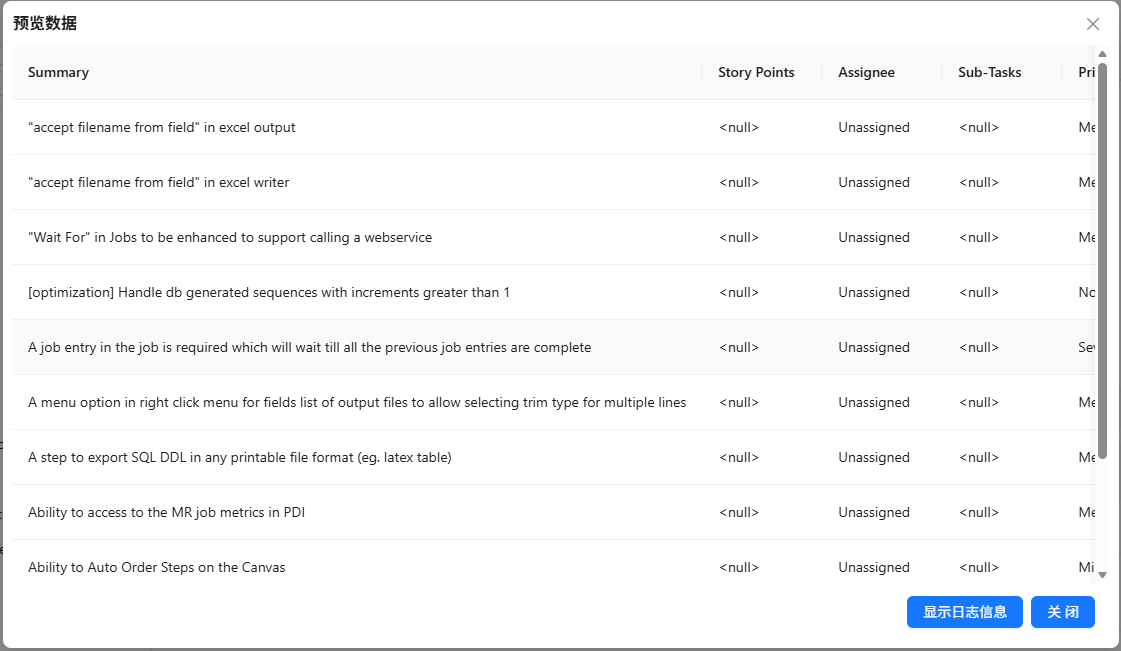
分别预览三个Excel输出组件的数据,结果应完全一致。
数据分发
本小节将对比展示"复制发送"与"随机分发"两种数据流分发方式的差异。这对于理解分布式场景下数据如何在不同输出通道间分配具有重要意义。
与"复制发送"不同,随机分发模式下,数据不会完整复制到每个输出,而是将输入行随机拆分成若干份,分别发送到不同的输出组件。随机分发的价值在于:当数据量过大需要并行写入多个目标、但每个目标只需处理部分数据时,可以有效分摊存储压力或提升吞吐效率。
操作步骤
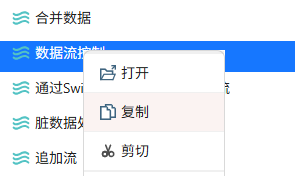
- 复制转换:复制上一节"控制数据流"粘贴后重命名为数据分发
- 修改分发方式
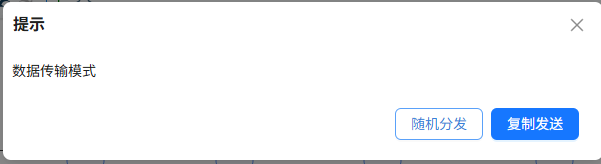
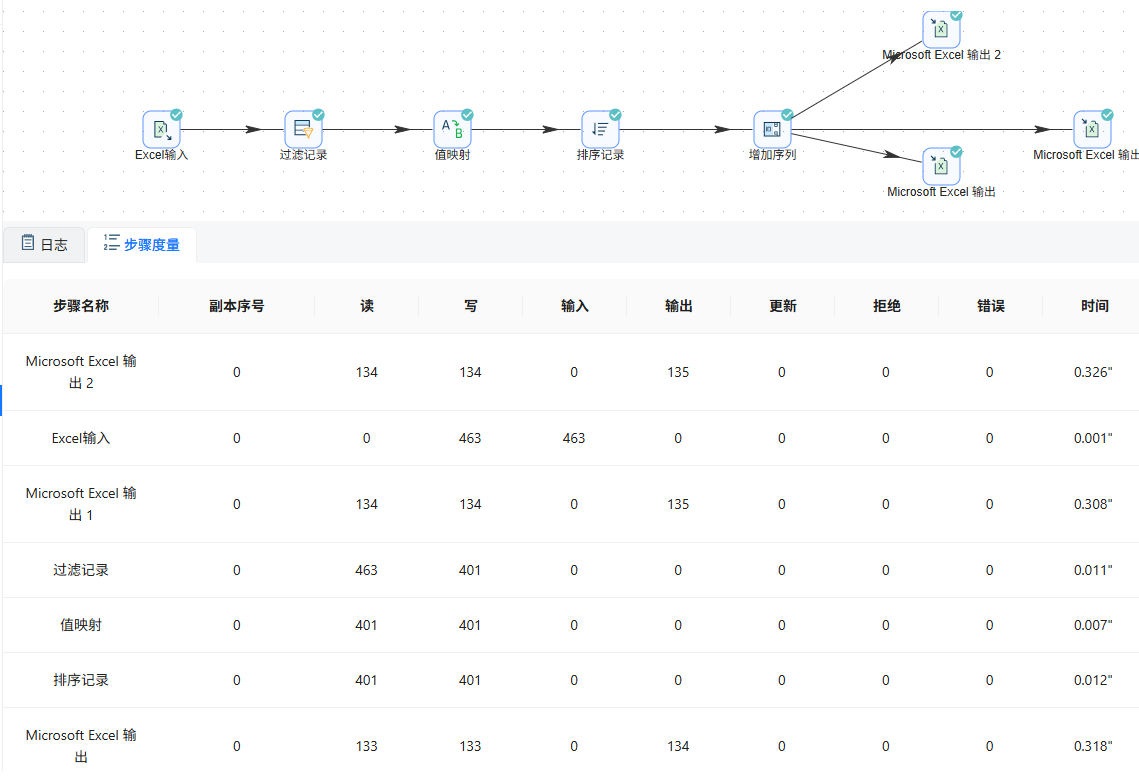
依次连接步骤,在连接最后三个Excel输出步骤时,连接方式选择随机分发。
- 运行转换
点击「运行」执行转换。
- 预览结果
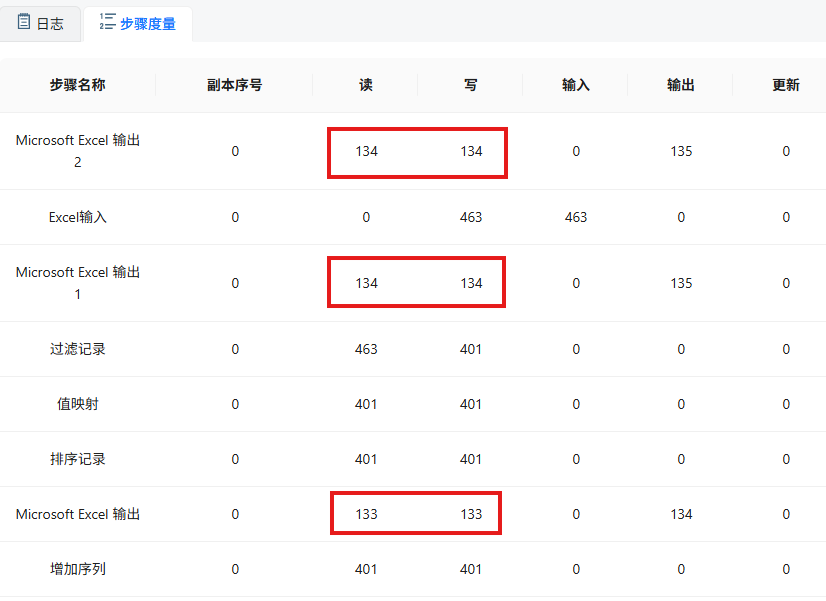
分别预览三个Excel输出组件,可以看到每个输出组件的数据都不相同。选择随机分发后,数据会按行被分成n等份(n为输出步骤个数),随机分发至每个输出组件。
通过"Switch/Case"组件控制数据流
本小节展示如何用「Switch/Case」(按值分发)组件实现条件分支路由。
「过滤记录」只能做二元分流(满足条件/不满足条件),而Switch/Case支持多路条件判断——根据某个字段的具体值,将数据路由到多个不同的输出目标,每个输出对应一种取值情况。它的典型应用场景包括:按地区分发数据到不同区域的数据表、按订单状态分流到不同的处理流程、按错误类型分类记录等。这种"一入多出"的模式为构建复杂业务规则引擎提供了有力支撑。
操作步骤
1-3. 添加并配置Excel输入组件
与上一节相同方式添加并配置 Pentaho+BI+Platform+Tracking.xls 文件,工作表起始行为3、起始列为1,获取字段。
- 添加过滤记录组件
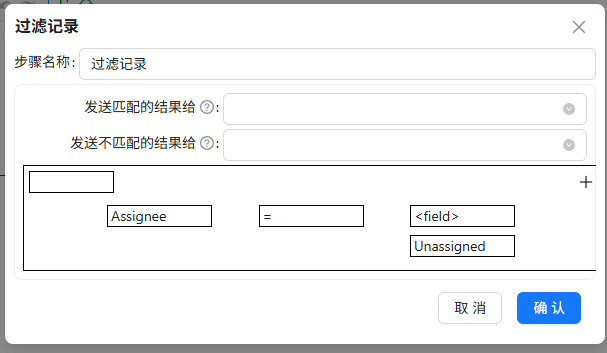
拖拽「过滤记录」组件,配置过滤条件去除无效数据。
- 添加Switch/Case组件及四个Excel输出
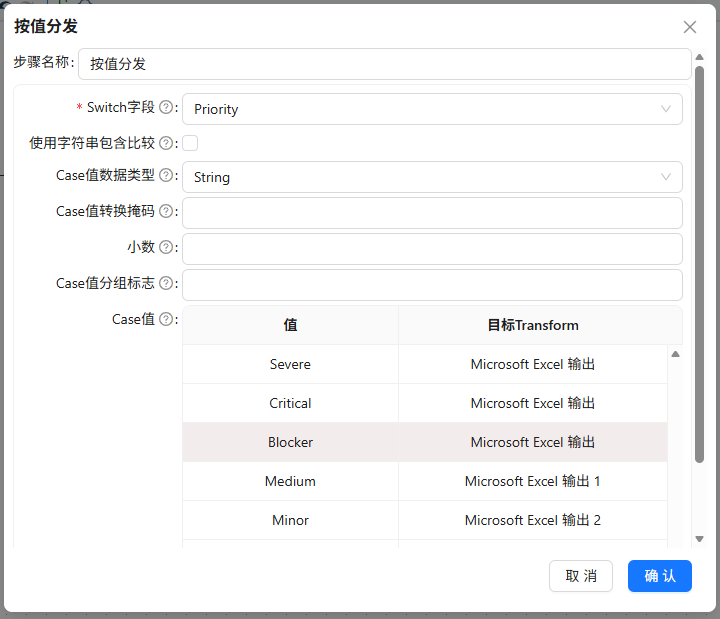
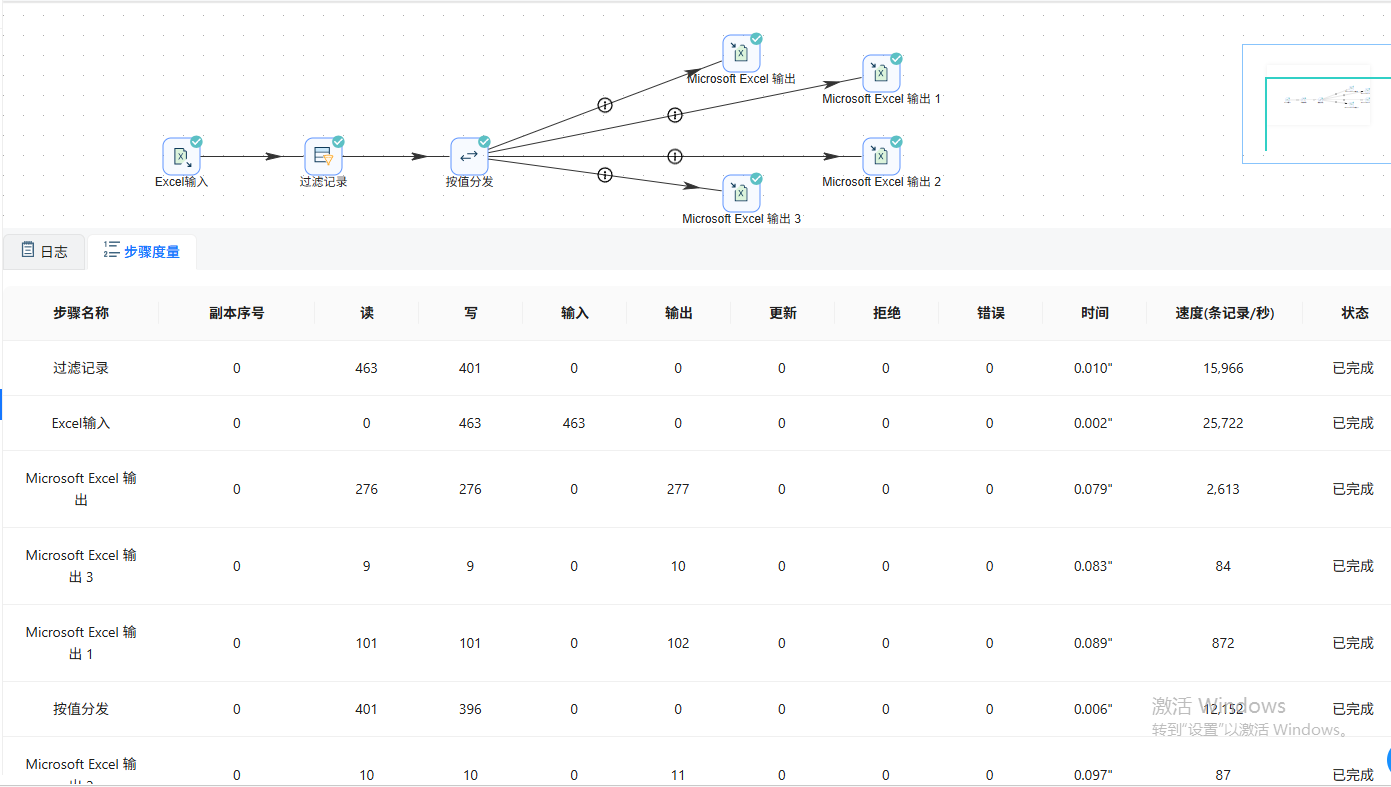
从「流程」面板拖拽「Switch/Case」组件至画布,连接过滤记录组件。从「输出」面板拖拽四个「Excel输出」组件,分别与Switch/Case组件建立连接。excel组件配置时文件名分别命名为file,file1,file2,file3。
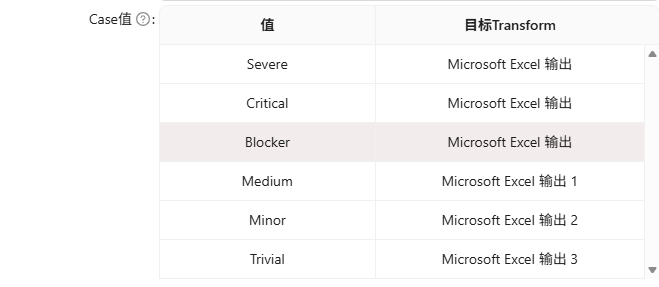
- 配置Switch/Case
双击「Switch/Case」组件,选择用于分支判断的字段,配置多个条件及其对应的目标输出步骤。
- 运行转换并预览结果
点击「运行」执行转换。
分别预览四个Excel输出组件,验证每个输出是否对应该Switch/Case所设定的条件。
合并数据
本小节演示如何将两个结构相似的数据源合并为单一数据集。
在真实业务中,数据往往分散在不同文件或表中——例如不同年份的销售记录、不同区域的客户信息、不同来源的日志数据。将这些分散的数据整合到一起进行统一分析,是ETL流程中极为常见的需求。
合并数据的方式有多种:通过「增加序列」组件支持多个输入流,可将多个数据源合并为单一数据集;通过「追加流」组件则以流式方式追加数据,灵活适配不同场景。
操作步骤
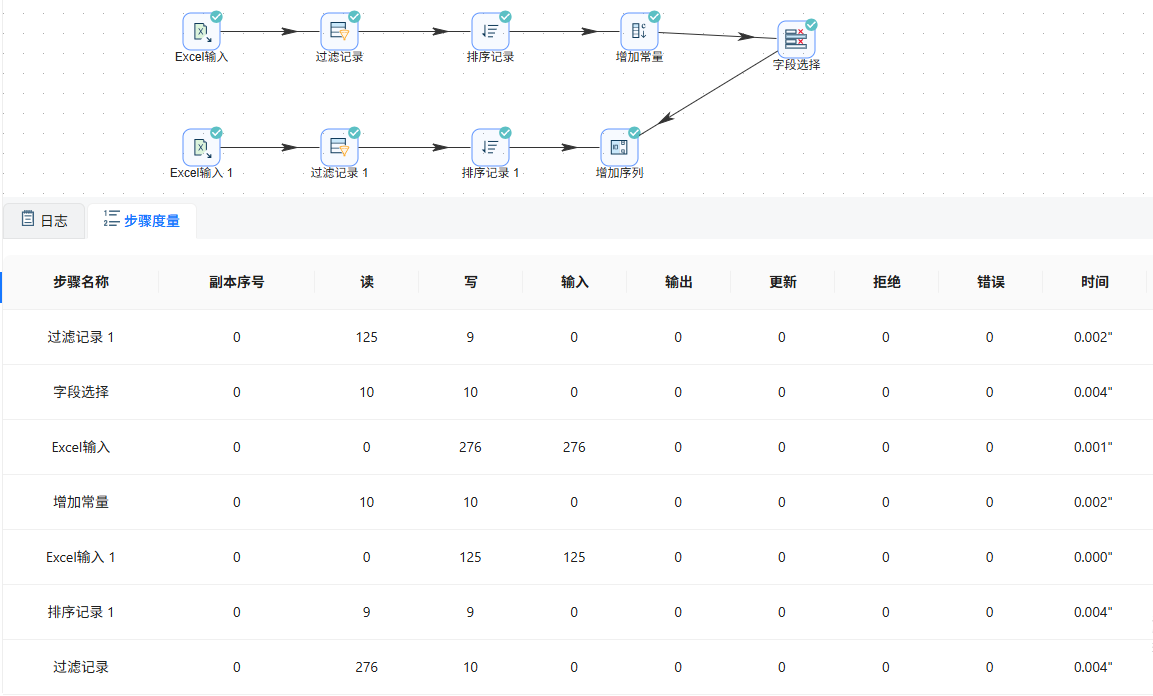
- 处理第一个数据源
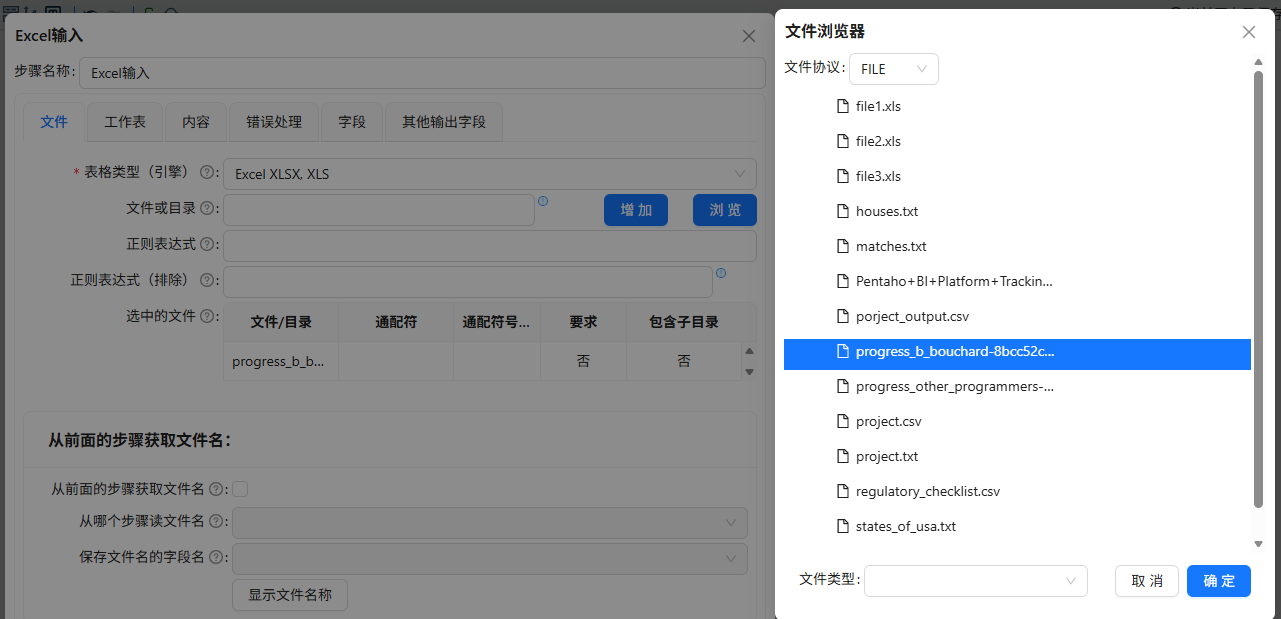
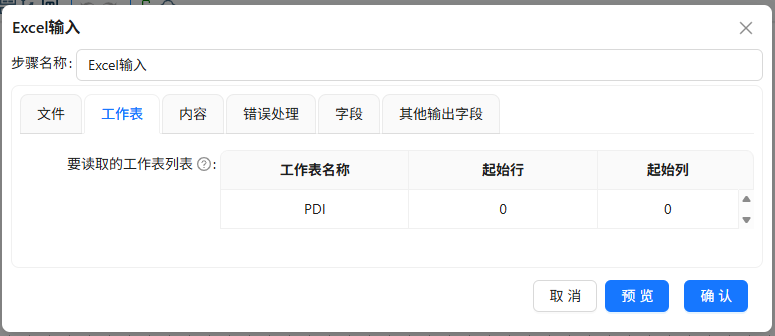
从「输入」面板拖拽「Excel输入」组件,选择 progress_b_bouchard.xls,配置工作表(起始行1、起始列1),获取字段。
-
「过滤记录」:过滤
Progress字段为空的数据——空进度记录无分析价值,排除后可聚焦有效数据 -
「排序记录」:按指定字段排序,确保数据进入合并步骤时顺序一致
-
「增加常量」:新增
Programmer字段,值为"Benjamin Bouchard"——这一步是关键,为来自该文件的所有记录打上固定的程序员标签,使下游能够区分数据来源 -
「字段选择」:仅保留后续合并所需的字段,剔除冗余列,精简数据结构
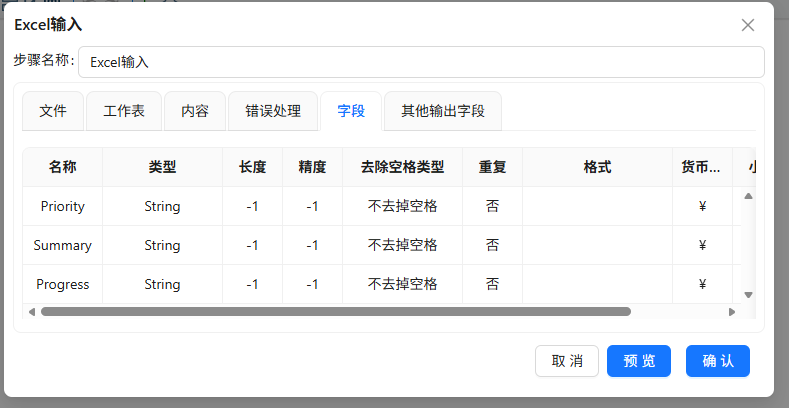
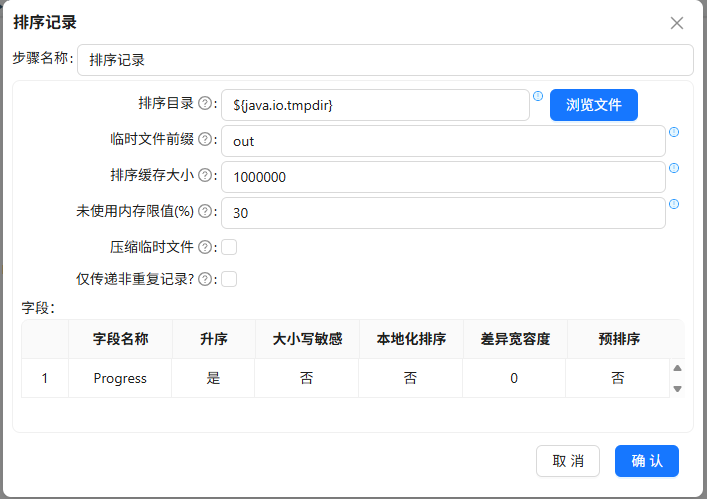
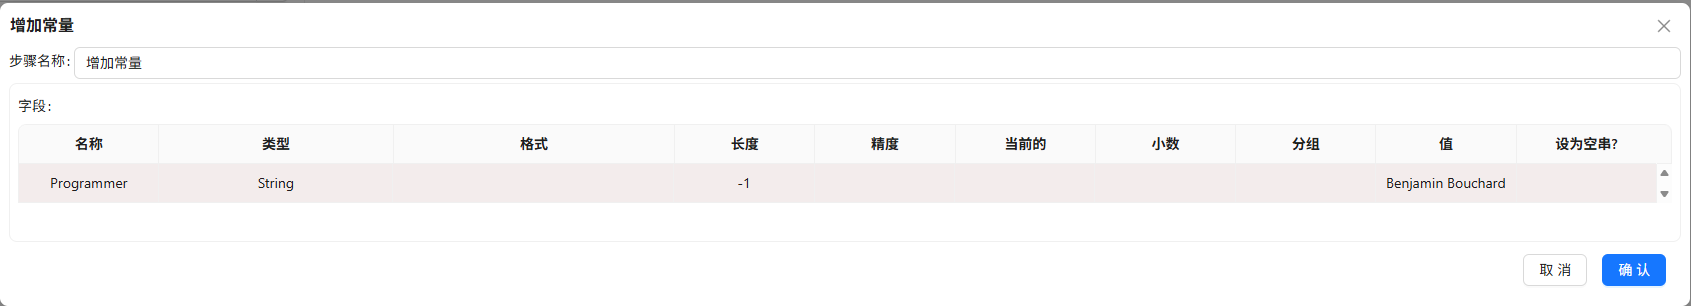
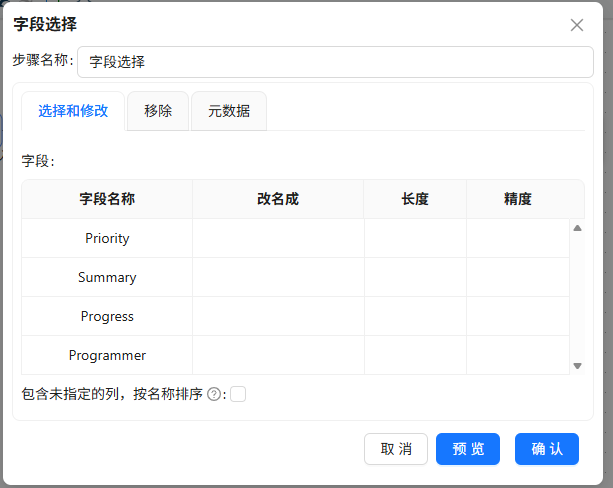
- 第二个数据源处理流程
以同样方式添加第二个「Excel输入」组件,选择 progress_other_programmers.xls,配置工作表、获取字段。同样添加「过滤记录」和「排序记录」组件。
- 添加增加序列组件合并数据
拖拽「增加序列」组件至画布,将第一个数据源的字段选择组件和第二个数据源的排序记录组件同时连接至增加序列组件。
- 运行转换并预览结果
点击「运行」执行转换。
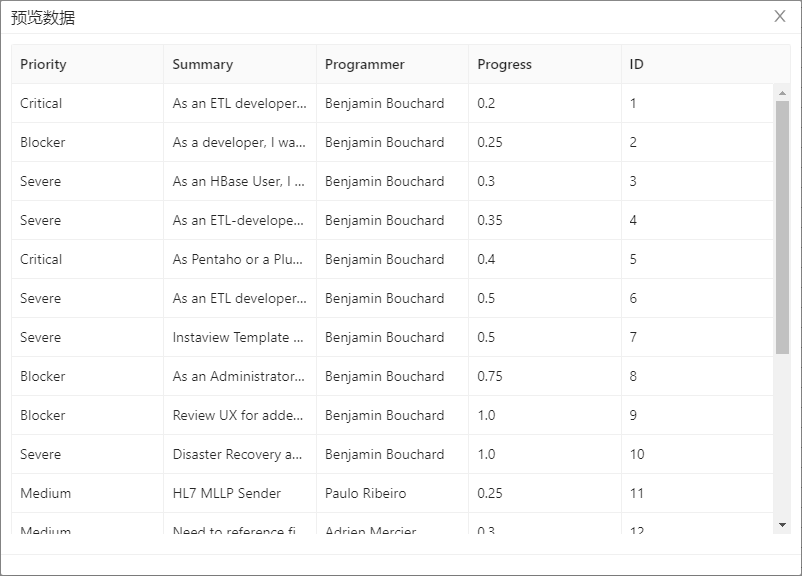
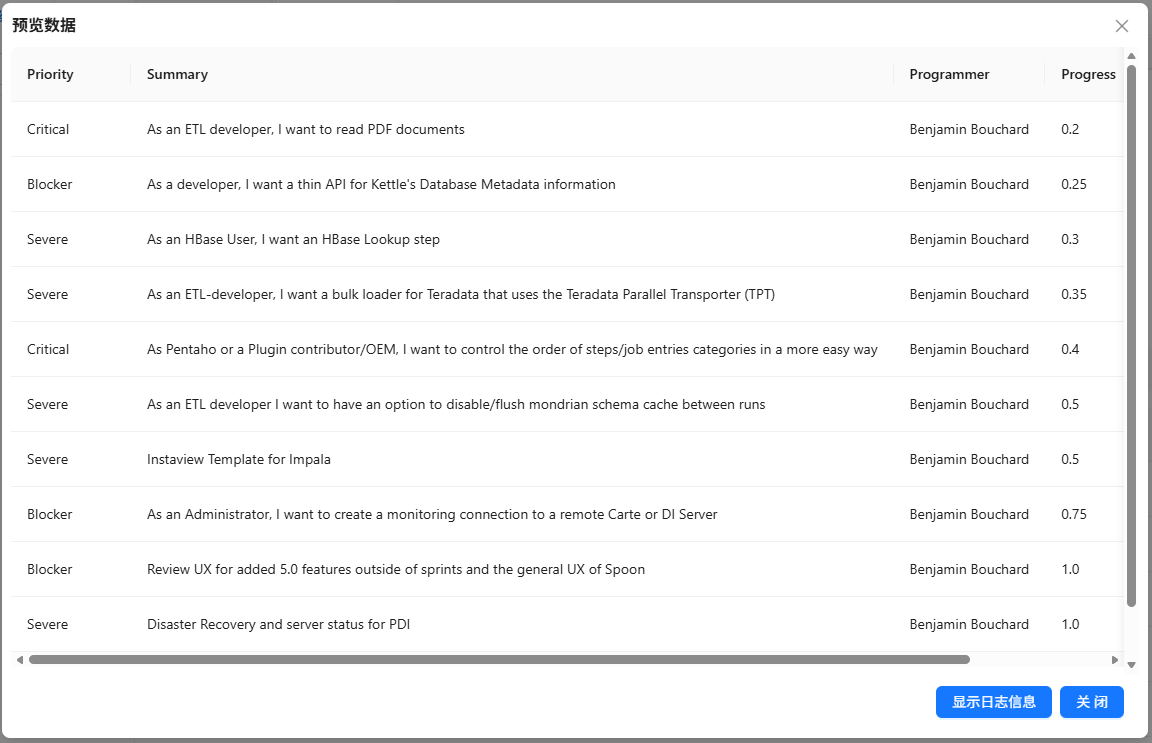
选中「增加序列」组件,右键「预览输出」,可观察到两个数据源合并后的完整数据。
使用"追加流"组件合并数据流
小节在上节基础上,使用「追加流」组件实现数据合并。「追加流」与「增加序列」在合并方式上的核心区别在于:追加流是纯粹的流式拼接,不附加任何额外处理(如排序、去重);而增加序列在合并的同时还能生成序号,定位介于"数据准备"和"数据输出"之间。「追加流」更接近一个纯流程控制组件,适合将多个已完成清洗的数据流简单拼合后统一输出。
操作步骤
1-3. 复制转换并调整连接
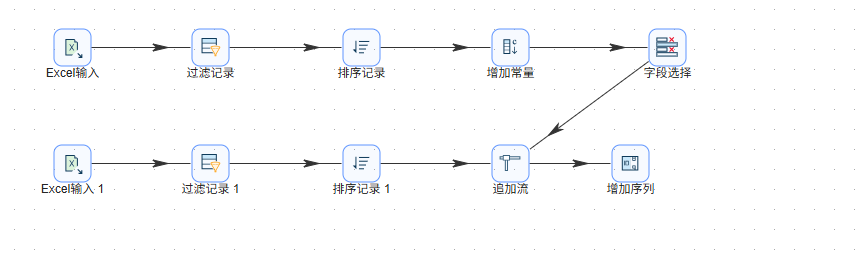
复制上一节"合并数据"转换中的所有步骤到新转换中。删除从字段选择到增加序列之间的连接。
- 添加追加流组件
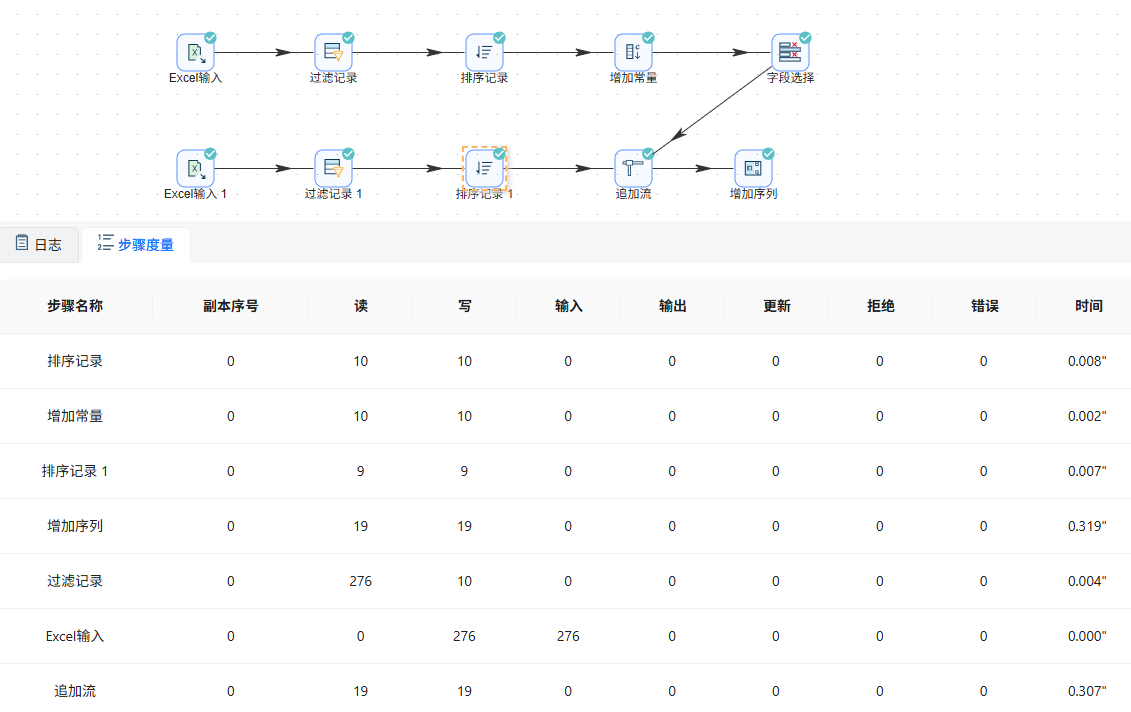
从「流程」面板拖拽「追加流」组件至画布,将第一个数据源的「字段选择」组件和第二个数据源的「排序记录」组件同时连接至「追加流」组件,再将「追加流」组件连接至「增加序列」组件。
- 配置追加流组件
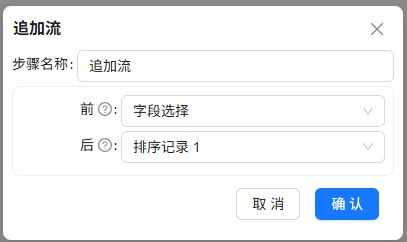
双击「追加流」组件,配置追加方式。注意,需确保两个数据源的字段全部一致且顺序一致,不然会报错。
- 运行转换并预览
点击「运行」执行转换,预览增加序列组件的数据,结果与上一节一致。
脏数据处理
说明:本小节配置内容与【使用助睿ETL实现异常数据处理与容错机制】实验基本相同,相同配置步骤已简化。
在数据处理过程中,脏数据(格式错误、字段缺失、异常值等)不可避免。本小节演示如何通过错误捕获机制为异常字段赋予默认值,确保ETL流程的健壮性。
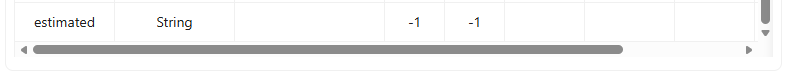
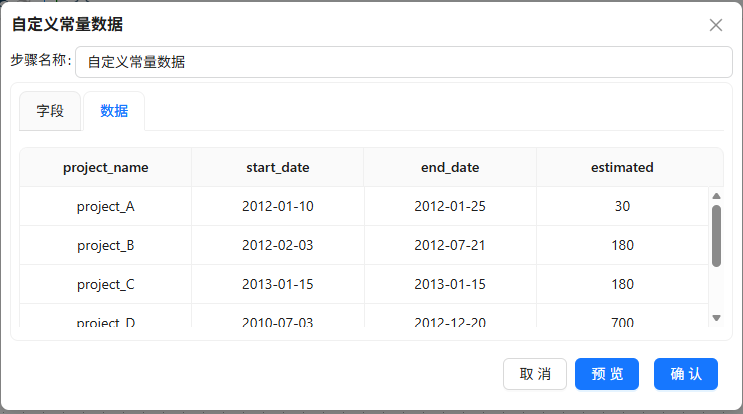
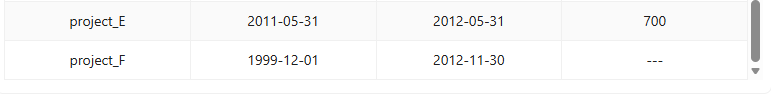
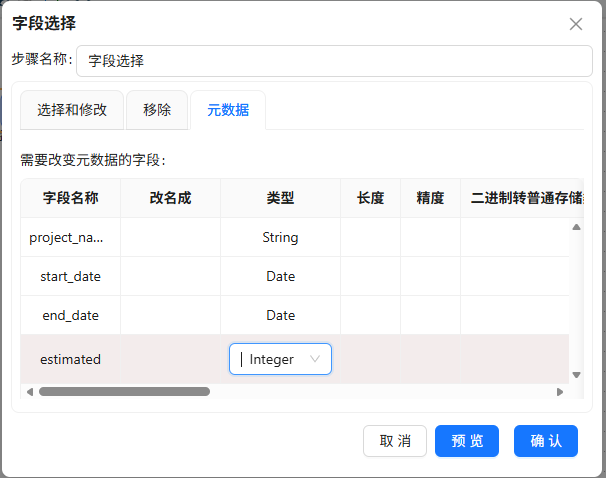
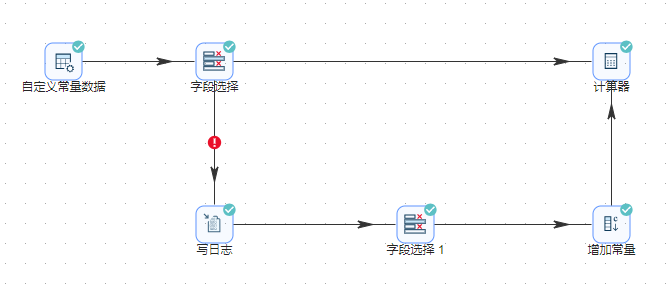
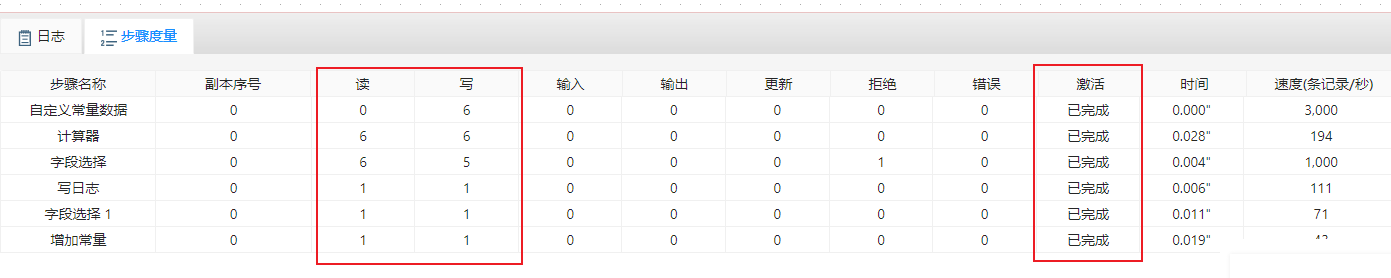
核心思路:通过字段选择组件将 estimated 字段的类型从 String 转为 Integer,第6行的非数字内容会触发类型转换错误。错误数据通过错误输出分支流向写日志组件记录错误信息,同时经增加常量组件为 estimated 字段赋予默认值180,最终与正常数据汇合后继续向下游传递。
操作步骤
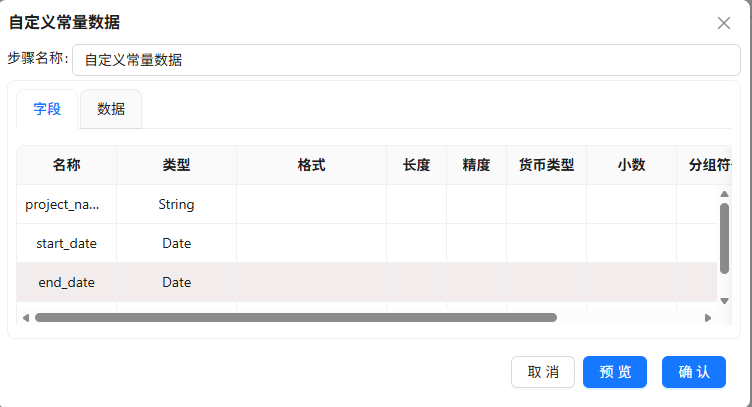
- 添加自定义常量数据组件
拖拽「自定义常量数据」组件至画布,配置如下:
- 添加字段选择组件(触发错误)
拖拽「字段选择」组件,在「元数据」标签页中将 estimated 字段类型从 String 改为 Integer,精确保留原始值而非设为空。此处主动触发类型转换,当遇到非数字内容时产生错误。
- 添加写日志组件(捕获错误)
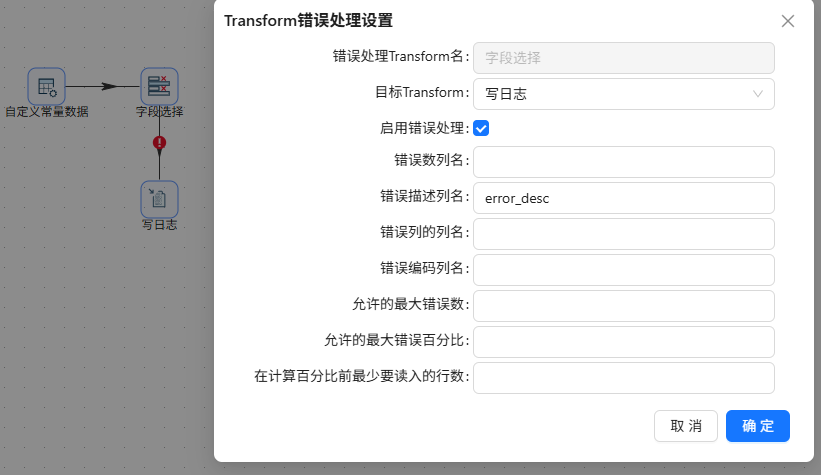
拖拽「写日志」组件,建立从「字段选择」到「写日志」的错误输出步骤连接。在点击红色感叹号后弹出的「定义错误处理」对话框中,错误描述列名输入 error_desc。
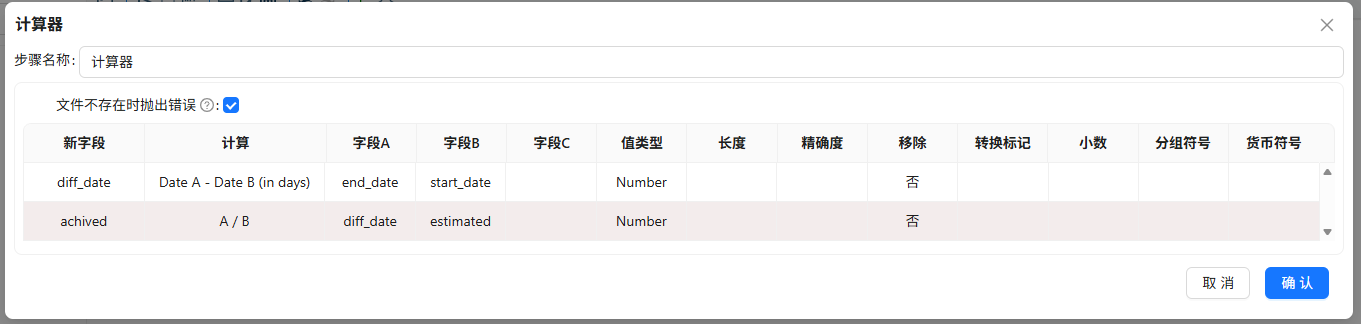
- 添加计算器组件
从「转换」面板拖拽「计算器」组件,连接「字段选择」组件的主输出步骤。正常数据进入此分支。
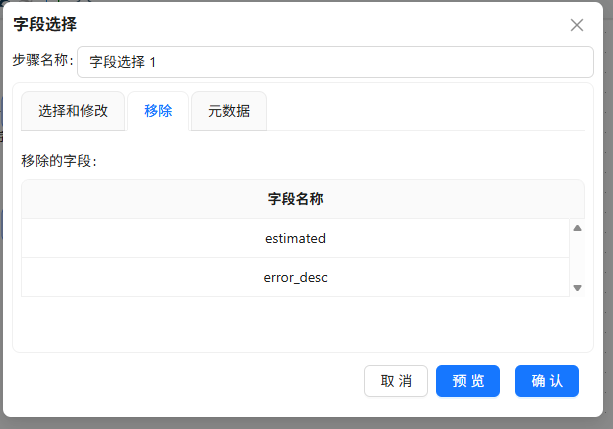
- 添加字段选择组件(配置错误链路字段)
从「转换」面板拖拽第二个「字段选择」组件,连接至「写日志」组件的主输出步骤,用于配置错误数据输出时的字段结构。
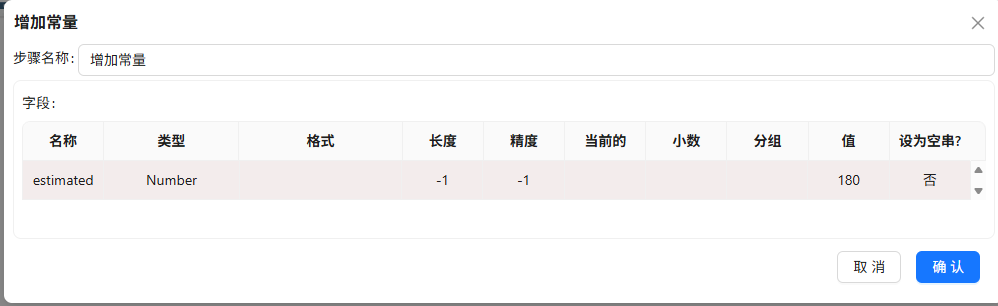
- 添加增加常量组件(设置默认值)
从「转换」面板拖拽「增加常量」组件。建立连接:从「字段选择」(错误链路)→「增加常量」→「计算器」组件(与正常数据流汇合)。双击「增加常量」组件,配置新增字段:字段名 estimated,类型 Integer,值 180。
正常数据流和错误处理流在「计算器」处汇合——正常数据保留原始 estimated 值,错误数据被赋予默认值180。
- 完整转换并运行并预览结果
完整转换流程为:Data Grid → 字段选择 → (主输出)计算器;(错误输出)写日志 → 字段选择 → 增加常量 → 计算器。点击「运行」执行转换。
总结
本实验通过五个典型场景,系统性地演示了助睿ETL中数据流控制的核心方法:
| 场景 | 核心技术 | 关键组件 |
|---|---|---|
| 控制数据流 | 数据复制分发 | 复制发送、过滤记录、值映射、增加序列 |
| 数据分发 | 随机分发 | 随机分发、复制发送对比 |
| Switch/Case控制 | 条件分支路由 | Switch/Case、条件判断 |
| 合并数据 | 多流汇合 | 增加序列(多输入) |
| 追加流合并 | 流式合并 | 追加流 |
| 脏数据处理 | 错误捕获与默认值替换 | 字段选择(错误输出)、写日志、增加常量 |
核心要点:
-
数据分发方式:复制发送将完整数据集发送至所有输出;随机分发将数据集随机拆分为多份
-
条件路由:Switch/Case组件可根据字段值将数据路由至不同目标,适用于多分支业务场景
-
数据合并:增加序列组件支持多个输入流,可将多个数据源合并为单一数据集;追加流组件以流式方式合并数据
-
脏数据容错:通过错误输出分支捕获转换异常,配合默认值替换确保流程不中断
本次实验帮助掌握了数据流控制的核心操作与设计思路,为构建复杂ETL流程奠定了基础。