案例说明
在数据仓库建设过程中,维度表的管理是最基础也是最关键的环节之一。维度表为事实数据提供描述性的上下文信息——客户是谁、产品是什么、交易发生在何时何地——没有高质量的维度表,数据仓库就无法回答有意义的业务问题。
维度表处理的核心挑战集中在三个方面:
- 代理键的生成与管理。数据仓库最佳实践表明,维度表应使用自动生成的无业务含义的整型数值作为代理键(Surrogate Key)。代理键独立于源系统的自然键,能够隔离业务系统变化对数据仓库的影响,同时为缓慢变更维度提供版本跟踪的基础。
助睿ETL 提供了两种生成代理键的方式:
一种是基于转换,通过「增加序列」组件配合最大值查询来计算偏移量。
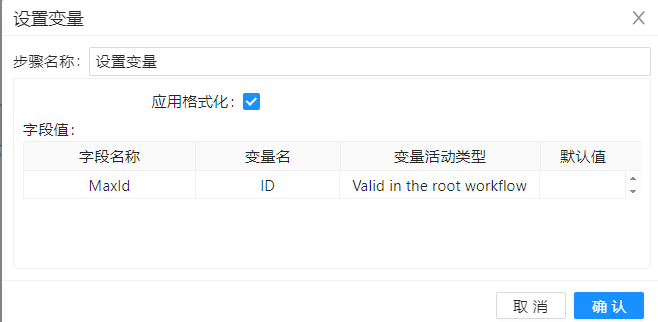
一种是基于作业,通过「设置变量」组件将最大值传递给下游转换作为序列起始值,主转换更加干净清晰。
-
维度表的分层加载。在实际建模中,维度表之间往往存在层次依赖关系——例如“国家→城市→地址”的雪花结构。加载时必须按照自顶向下的顺序逐层处理,确保子维度引用的父维度代理键已经存在。助睿ETL 通过作业(Job)编排多个转换,能够精确控制这种加载顺序。
-
缓慢变更维度的处理。根据 Kimball 的理论,缓慢变更维度(Slowly Changing Dimension, SCD)主要有三种类型:
-
类型1:直接覆盖更新,不保留历史,适用于错误修正类场景
-
类型2:插入新行并维护版本字段,完整保留历史变化轨迹
-
类型3:增加新列保存变化前后的值,仅保留有限历史
助睿ETL 的「插入/更新」组件可快速实现类型1,「维度查询/更新」组件则同时覆盖类型1和类型2,并能在加载事实表时自动查询正确版本的维度代理键。
本实验将基于经典的 Sakila 示例数据库展开。该数据库包含电影、演员、客户、租赁等典型业务表,结构清晰且覆盖了数据仓库维度建模的常见场景。
实验环境
-
平台名称:助睿在线实验平台
-
使用产品:助睿数智(Uniplore)- AI驱动的一站式数据智能服务平台系统
-
子平台:助睿ETL数据集集成平台
数据准备
本实验需要以下 SQL 脚本文件,请从平台「公共空间」导出或下方链接获取后,在数据库中依次执行:
| 脚本文件 | 用途说明 |
|---|---|
| sakila-schema.sql | 创建 Sakila 数据库结构(表、视图、存储过程、触发器) |
| sakila-data.sql | 填充初始数据 |
| sakila_snowflake_schema.sql | 创建雪花模型维度表 |
操作步骤:
-
在数据库中依次执行
sakila-schema.sql和sakila-data.sql,完成源数据库的初始化 -
执行
sakila_snowflake_schema.sql,创建雪花模型所需的维度表结构 -
确认数据库连接配置正确,助睿ETL 可正常访问该数据库
说明:本实验从源数据库 Sakila 抽取增量数据,加载到雪花模型的维度表中。涉及的维度表包括
dim_location_country(国家)、dim_location_city(城市)和dim_location_address(地址),三者构成“国家→城市→地址”的层次依赖关系。
生成代理键的两种方法
在数据仓库中,代理键是维度表的基石。助睿ETL 提供了两种生成代理键的方式:一种完全在转换内完成,另一种通过作业配合变量实现。两种方法各有适用场景——前者适合一次性加载或简单场景,后者适合需要反复运行的增量加载流程。
方法一:基于转换的代理键生成
该方法在单个转换中完成代理键的生成,核心思路是:先用「增加序列」组件生成从1开始的递增序号,再通过查询维度表获取当前最大代理键值,将两者相加得到可用的新代理键。
操作步骤:
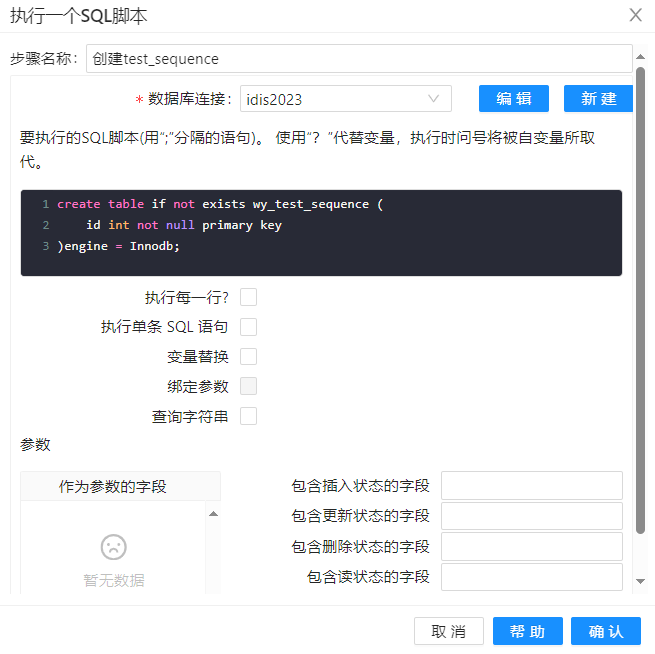
- 创建目标维度表
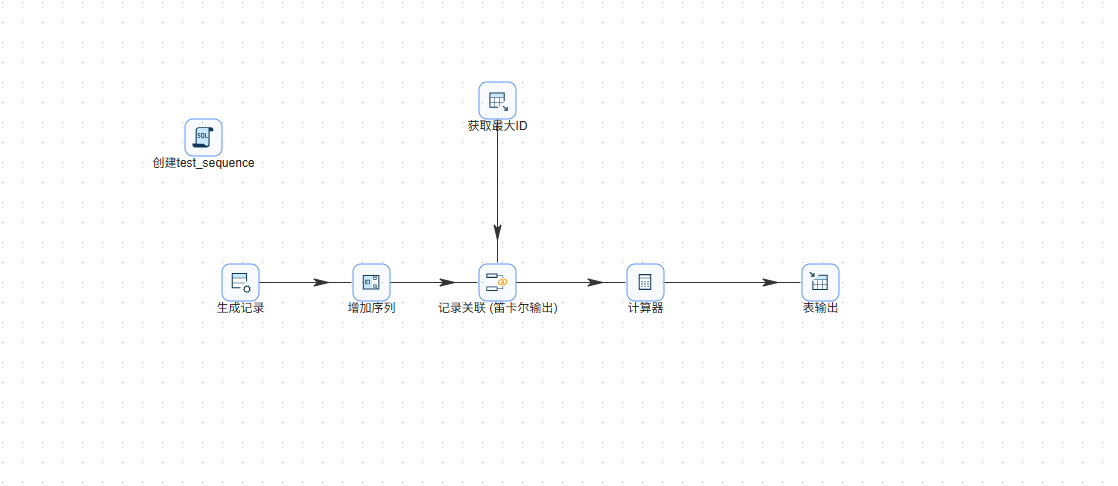
拖拽「执行 SQL 脚本」组件至画布,步骤名称设为“创建test_sequence”。在 SQL 编辑区输入建表语句,该表用于存储生成的代理键数据:
sql
CREATE TABLE IF NOT EXISTS wy_test_sequence (
id INT NOT NULL PRIMARY KEY
) ENGINE = InnoDB;
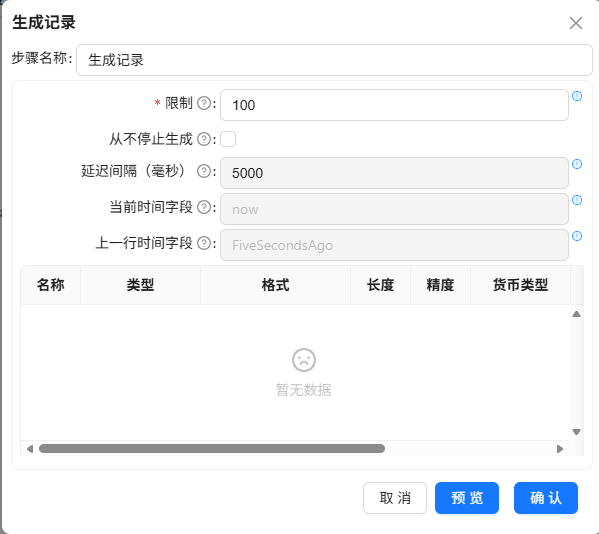
- 生成空记录
拖拽「生成记录」组件至画布,配置生成 100 行空记录。这些空行代表待加载到维度表中的数据量,每行将分配一个唯一的代理键。
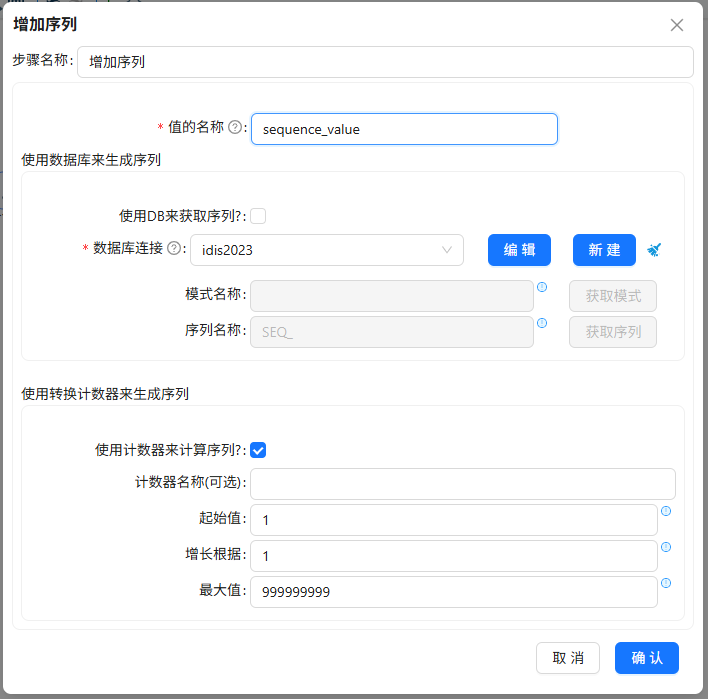
- 添加序列号
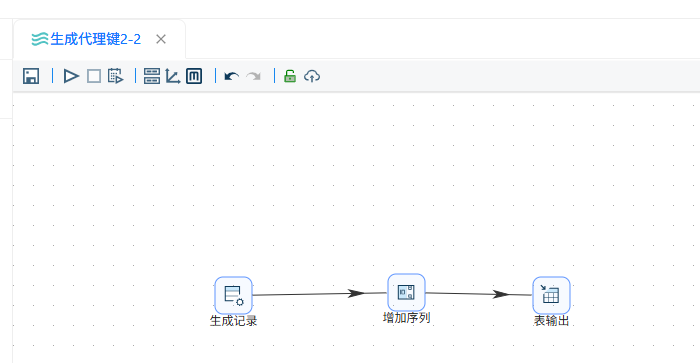
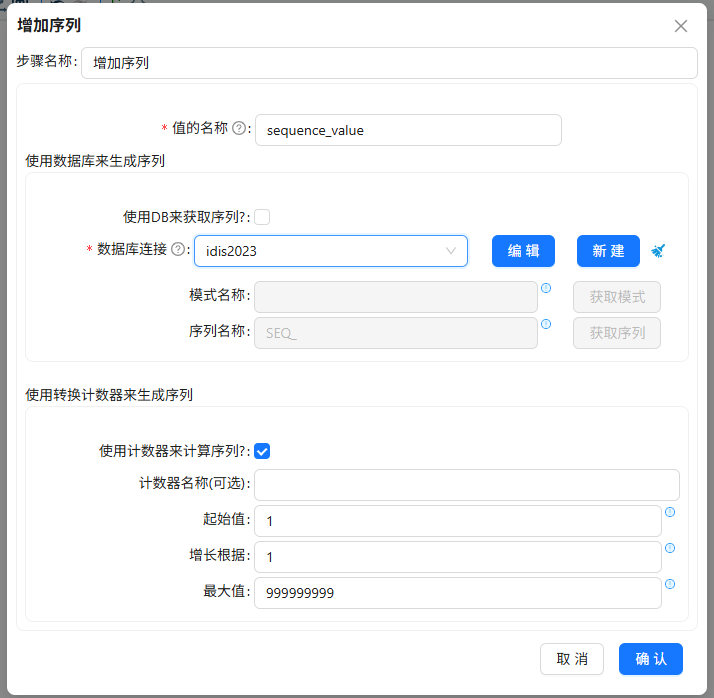
拖拽「增加序列」组件至画布,连接生成记录组件。配置该组件为数据流添加一个名为 sequence_value 的自增序列字段,起始值为 1,步长为 1。
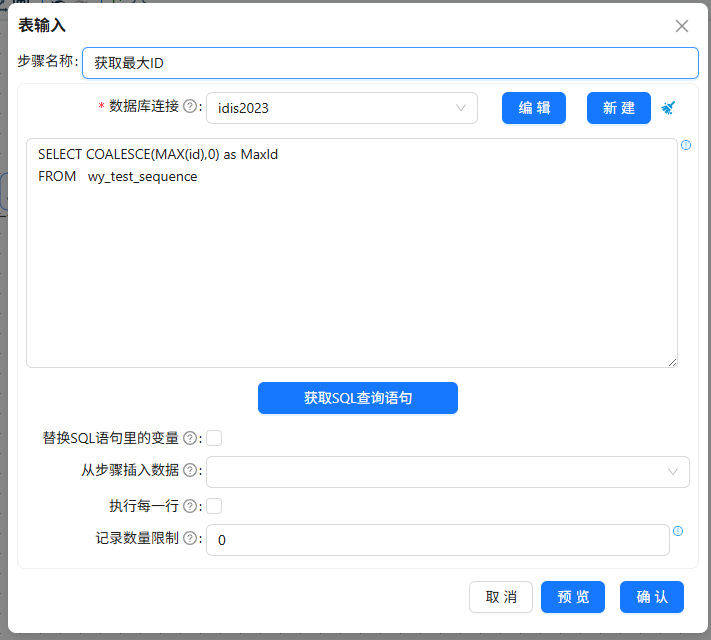
- 获取当前最大代理键
拖拽「表输入」组件至画布,执行以下 SQL 查询获取维度表中当前最大的 id 值。COALESCE 函数确保表为空时返回 0:
sql
SELECT COALESCE(MAX(id), 0) AS MaxId
FROM wy_test_sequence
- 关联最大值
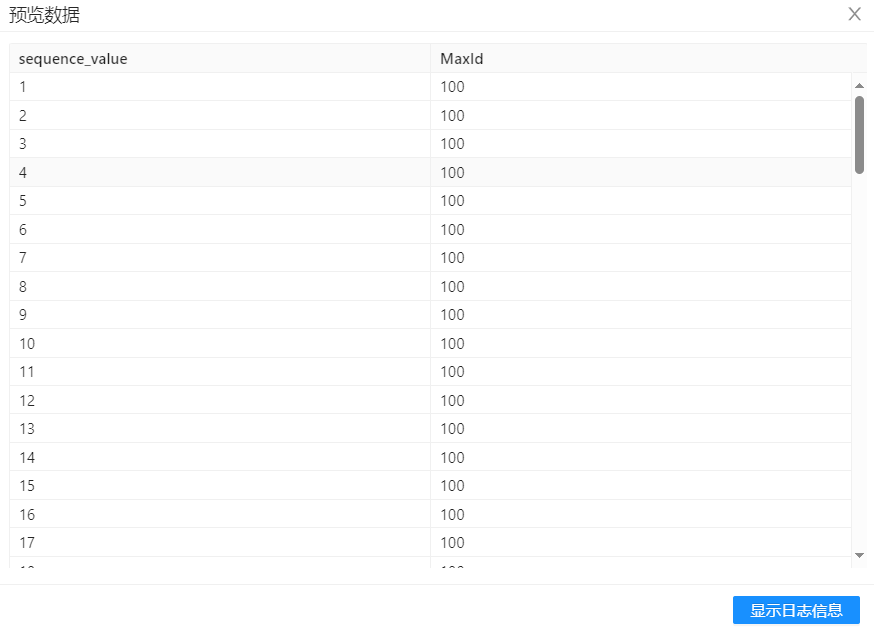
拖拽「记录关联(笛卡尔输出)」组件至画布,将“增加序列”的输出与“表输入”的输出进行关联。该组件为每一行数据附加一个 MaxId 列,使每条记录都能获得当前最大代理键值。
- 计算真实代理键
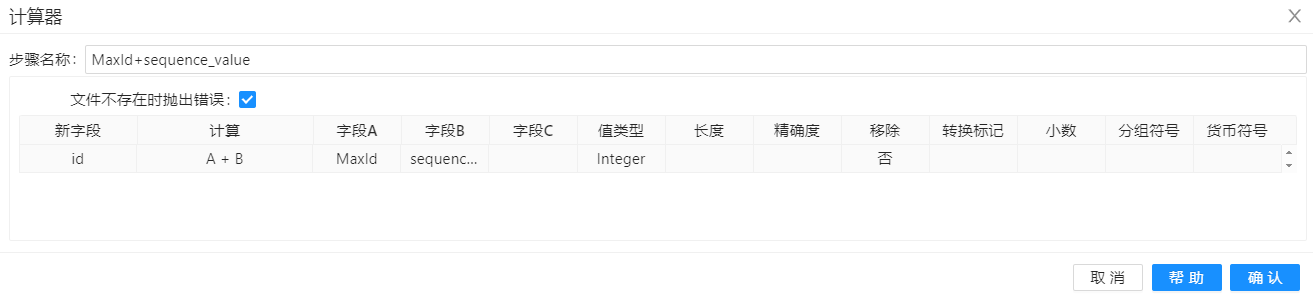
拖拽「计算器」组件至画布,配置计算逻辑:将 sequence_value 与 MaxId 相加,得到真正的代理键值。由于 MaxId 是所有记录共享的常量,第一条记录的代理键为 1 + MaxId,后续记录依次递增。
- 加载维度表
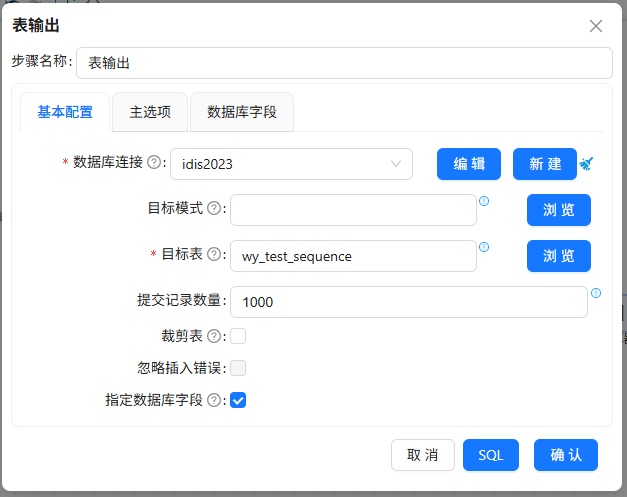
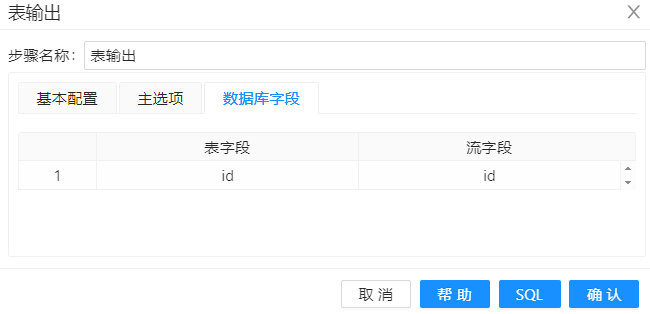
拖拽「表输出」组件至画布,选择目标表 wy_test_sequence,勾选“指定数据库字段”,建立表字段与流字段的映射关系(将计算后的代理键值写入 id 字段)。
- 完整流程图如图所示
- 运行转换并验证
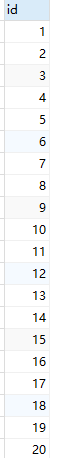
点击「运行」执行转换。在数据探查页面查询 wy_test_sequence 表,验证代理键从 1 开始依次递增。
方法一的特点:逻辑直观、易于理解,但存在两个局限——每次运行都需要查询最大值并对每一行做加法运算,当数据量较大时性能开销明显;同时大量步骤与核心加载逻辑无关,使转换显得臃肿。
方法二:基于作业的代理键生成
方法二通过作业(Job) 编排两个转换,利用「设置变量」组件将最大代理键值传递给下游转换,使「增加序列」组件在初始化时就能从正确的起始值开始生成。
这种方式的优势在于:主转换只需关注数据加载本身,代理键的偏移计算在独立的转换中完成,流程更清晰;且避免了逐行计算,性能更优。
操作步骤:
- 创建作业并添加两个转换组件
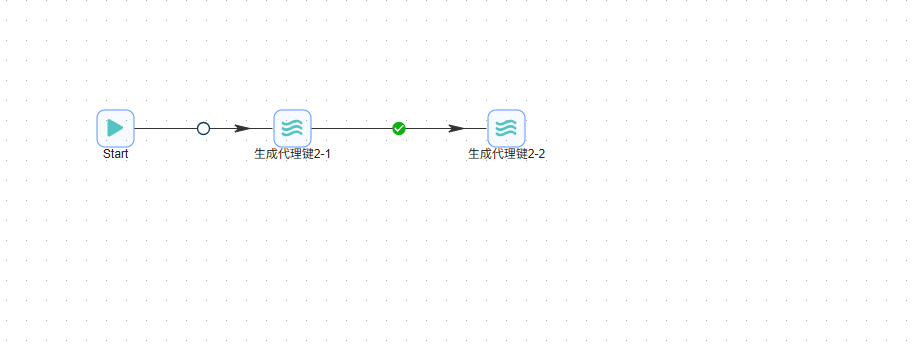
新建作业,从「通用」面板拖拽两个「转换」组件至画布,分别命名为“生成代理键2-1”和“生成代理键2-2”,用「START」组件连接两者。
- 配置第一个转换(获取最大值并设置变量)
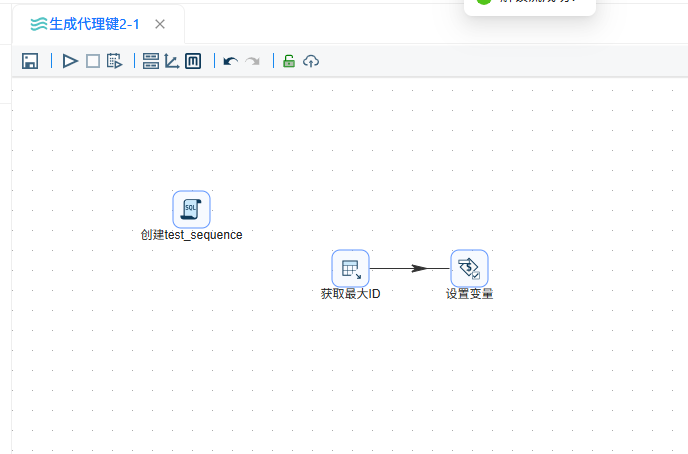
在“生成代理键2-1”转换中,使用「表输入」组件查询 wy_test_sequence 表的最大 id 值(SQL 与方法一相同)。拖拽「设置变量」组件,配置如下:
- 配置第二个转换(使用变量作为起始值)
在“生成代理键2-2”转换中,配置「增加序列」组件的起始值为变量 ${MAX_ID}。其余组件(生成记录、表输出等)配置与方法一相同。
- 运行作业并验证
点击「运行」执行作业。由于起始值已被正确设置为当前最大 ID + 1,新生成的代理键直接从正确值开始,无需额外计算。
方法二的优势:主转换干净清晰,代理键偏移逻辑与数据加载逻辑分离;避免逐行计算,性能更优;适合需要反复运行的增量加载场景。
维度表的自顶向下加载
在雪花模型中,维度表之间存在层次依赖关系。以地址维度为例:dim_location_address 依赖 dim_location_city(每个地址所属的城市必须存在),而 dim_location_city 又依赖 dim_location_country(每个城市所属的国家必须存在)。
加载顺序必须遵循 自顶向下 的原则:国家 → 城市 → 地址。如果先加载地址而城市维度表为空,地址中的城市外键将无法关联到有效记录。
作业编排
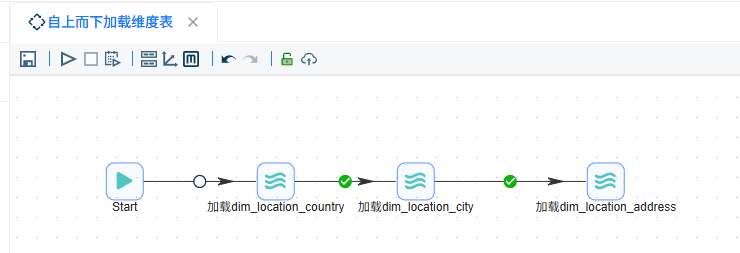
创建一个作业,从 START 组件开始,依次运行三个转换:
-
第一步:运行“加载 dim_location_country”
-
第二步:运行“加载 dim_location_city”
-
第三步:运行“加载 dim_location_address”
为什么必须串行执行? 每个转换的输入依赖于前一个转换的输出结果——城市转换需要国家维度中已存在的代理键,地址转换需要城市维度中已存在的代理键。并行执行会导致子维度无法获取父维度的代理键,加载失败。
各转换的核心逻辑
三个转换的加载逻辑高度相似,均采用 增量抽取 策略:
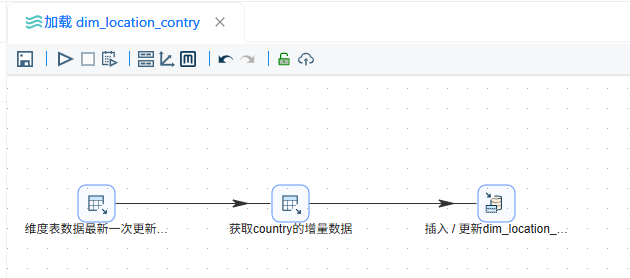
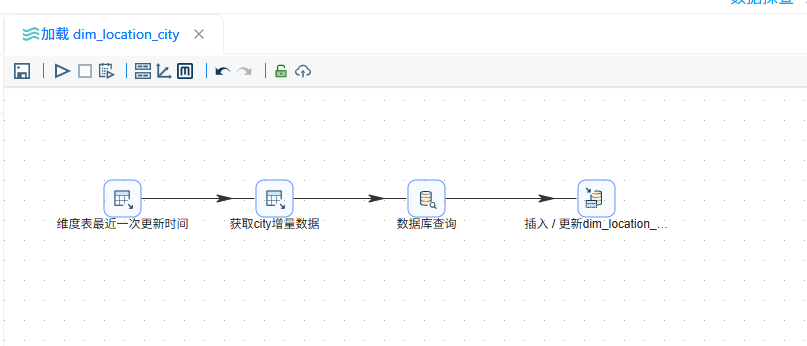
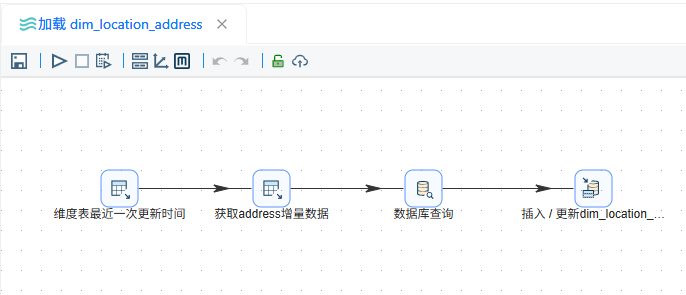
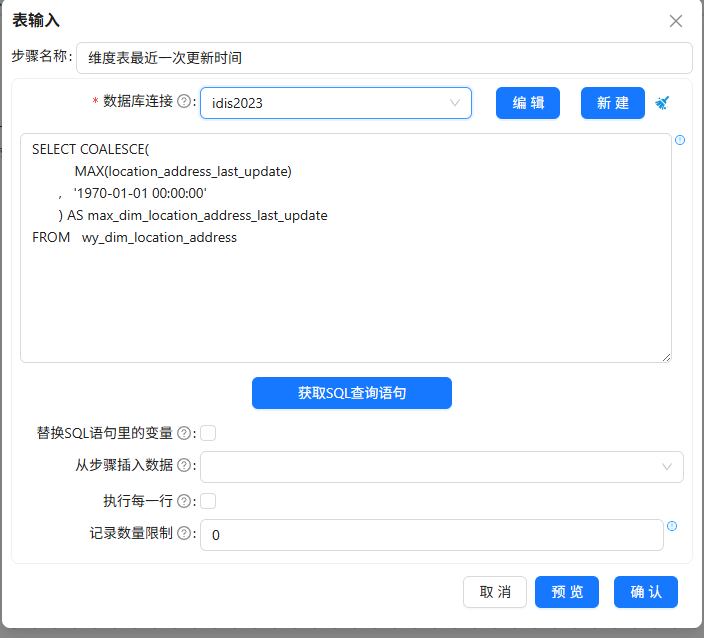
三个转换中利用"表输入"组件来获取维度表中数据的最新一次更新时间。因其逻辑相同,仅仅以 “加载 dim_location_address” 组件来做展示
- 获取维度表最后更新时间
使用「表输入」组件查询维度表的 last_update 字段最大值。若表为空,返回 1970-01-01 00:00:00。
sql
SELECT COALESCE(MAX(location_address_last_update), ‘1970-01-01 00:00:00’)AS max_dim_location_address_last_updateFROM wy_dim_location_address
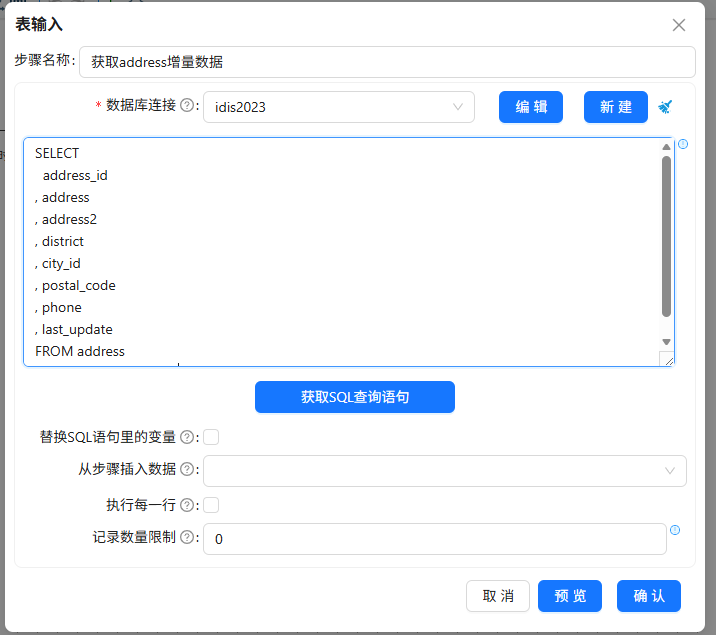
- 抽取增量数据
使用第二个「表输入」组件,根据上一步获取的时间戳,从源表 address 中筛选出 新增或更新的数据(last_update > ?):
sql
SELECT address_id, address, address2, district, city_id, postal_code, phone, last_updateFROM addressWHERE last_update > ?
参数 ? 由上游组件传入,实现了基于时间戳的增量抽取。
- 查询父维度代理键
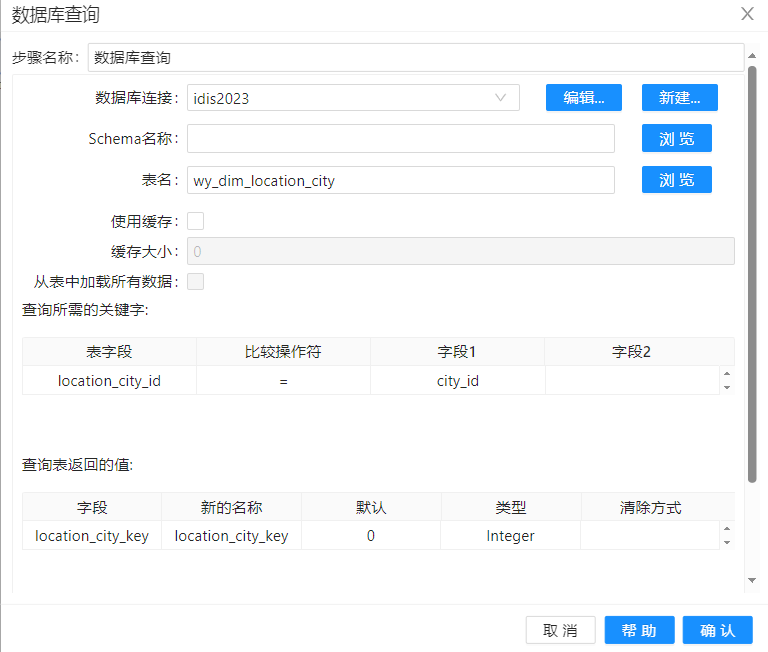
在“加载 dim_location_city”和“加载 dim_location_address”转换中,使用「数据库查询」组件根据业务键查询父维度的代理键——确保 dim_location_address 中的 city_id 在 dim_location_city 中存在,dim_location_city 中的 country_id 在 dim_location_country 中存在。以 “加载 dim_location_address” 为例子
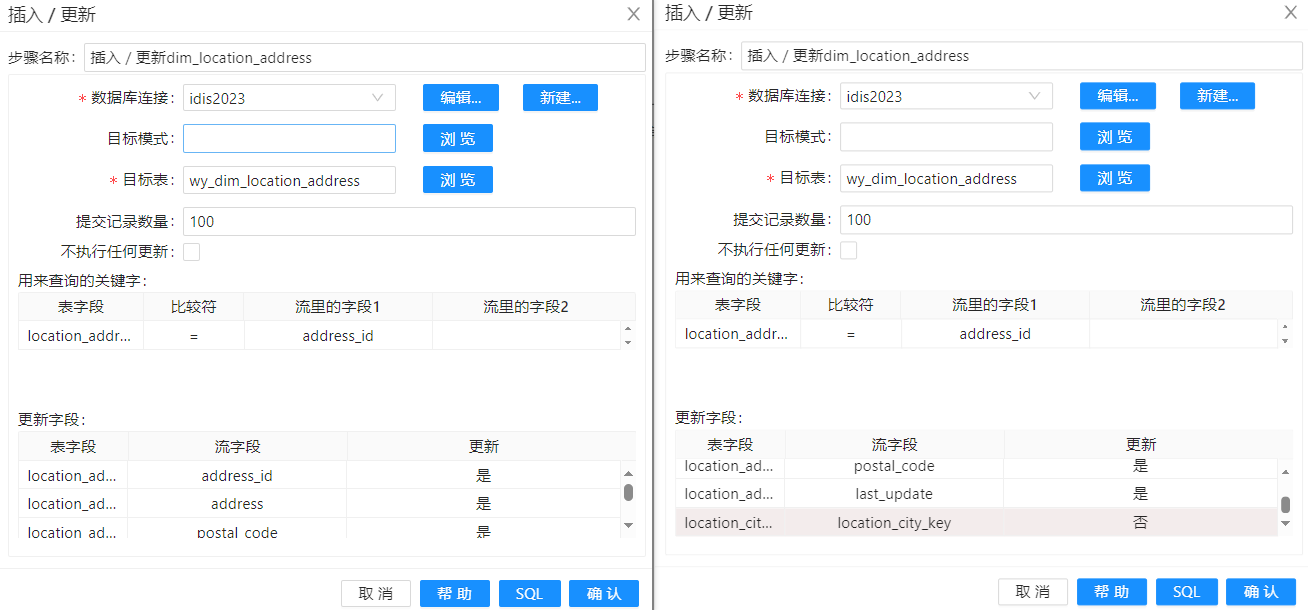
- 插入/更新维度表
使用「插入/更新」组件将增量数据加载到维度表中。该组件根据指定的关键字(如 address_id)判断记录是否存在:若存在则更新,若不存在则插入。
- 运行作业并验证
点击「运行」执行作业,完成后查询各维度表,验证数据已按正确的依赖顺序加载。
缓慢变更维度
根据 Kimball 的理论,缓慢变更维度(SCD)有三种基本类型:
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}| 类型 | 处理方式 | 历史保留 | 适用场景 |
|---|---|---|---|
| 类型1 | 直接覆盖更新 | 不保留 | 错误修正、属性值纠正 |
| 类型2 | 插入新行,维护版本字段 | 完整保留 | 需要跟踪历史变化的所有场景 |
| 类型3 | 增加新列保存变化前后值 | 有限保留 | 仅需保留上一次变化 |
助睿ETL 为两种最常用的类型提供了高效的原生支持。
缓慢变更类型1:直接覆盖
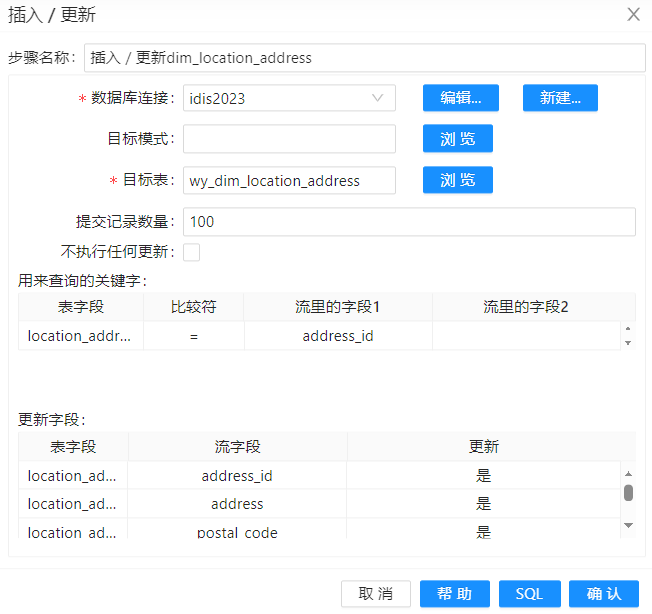
类型1是最简单的处理方式——当维度属性发生变化时,直接覆盖原有值,不保留任何历史信息。
实现方式:使用「插入/更新」组件即可完成类型1的缓慢变更处理。在“维度表的自顶向下加载”一节中,各转换使用的正是该组件——根据业务键判断记录是否存在,存在则更新所有字段,不存在则插入新记录。
性能提示:如果只需要插入数据且不担心主键冲突,可直接使用「表输出」组件配合错误处理,避免查询开销,性能更优。
缓慢变更类型2:保留历史版本
类型2是数据仓库中最常见的缓慢变更处理方式。每当维度属性发生变化时,不覆盖原有记录,而是插入一行新记录,通过版本号或时间戳字段区分同一业务键的不同版本。这使得数据仓库能够还原任意历史时点的维度状态——例如,“去年年底这个客户属于哪个区域?”
核心组件:「维度查询/更新」组件位于“数据仓库”类别下,支持两种模式:
-
更新模式:加载维度表时,自动判断是插入新版本还是更新现有记录,并自动维护版本号和时间戳字段
-
查询模式:加载事实表时,根据事实表中的日期字段自动获取对应时间点的正确维度版本
操作步骤:
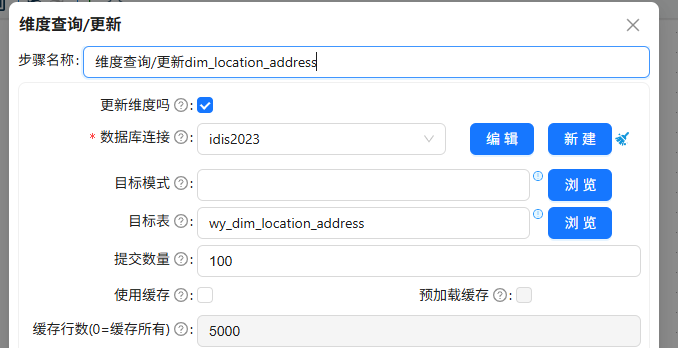
- 配置数据库连接
双击「维度查询/更新」组件,在“基本配置”中设置目标数据库连接及目标维度表。
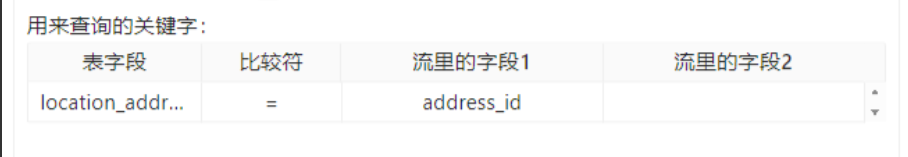
- 配置关键字(业务主键)
-
维字段:维度表中的业务主键(如
customer_id) -
流里的字段:数据流中对应的业务键字段
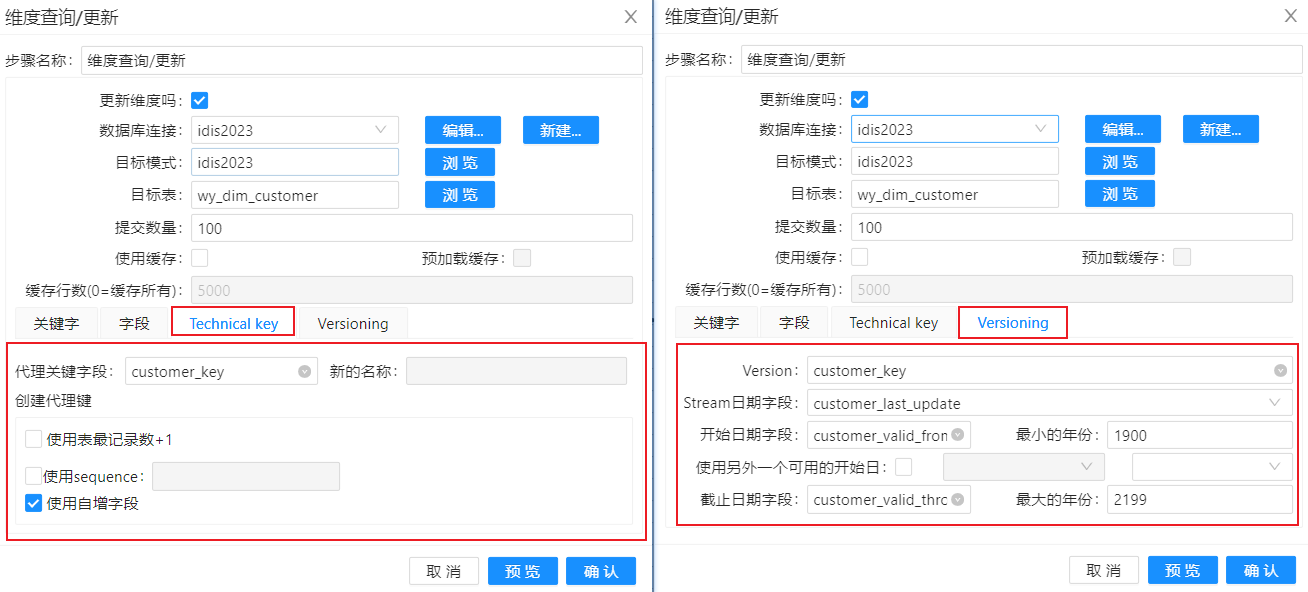
- 配置代理键生成方式
在“其它配置”中设置“创建代理键”选项,支持三种方式:
-
使用表最大记录数+1:查询代理键字段最大值后加1
-
使用数据库序列:指定数据库序列名称(需数据库支持)
-
使用自增字段:利用数据库的 AUTO_INCREMENT 或 IDENTITY 列
配置“Version 字段”用于存储版本号,“Stream 日期字段”用于记录变化时间,“开始日期字段”和“截止日期字段”用于定义维度的有效期。
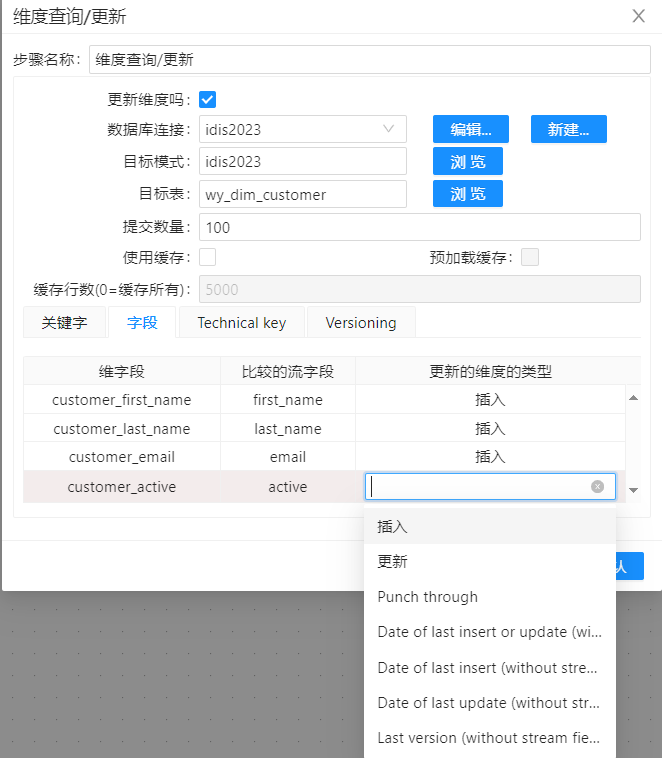
- 配置字段映射
切换至“字段”标签页,指定数据流字段与维度表字段的映射关系。对于每个字段,可单独选择变更处理策略——有些字段按类型1处理(直接覆盖),有些按类型2处理(触发新版本)。
- 运行并验证
执行转换,验证维度表中同一业务键的多条记录是否通过版本号正确区分。
总结
本实验系统性地介绍了 助睿ETL 在维度表管理中的核心功能与最佳实践:
代理键的生成与管理
-
方法一(基于转换):使用「增加序列」配合最大值查询,逻辑直观但性能有开销
-
方法二(基于作业):通过「设置变量」传递偏移量,流程清晰、性能更优
维度表的自顶向下加载
-
利用作业(Job)编排多个转换,严格控制“国家→城市→地址”的加载顺序
-
通过时间戳实现增量抽取,避免全量加载的性能浪费
缓慢变更维度
-
类型1:使用「插入/更新」组件直接覆盖,适用于错误修正
-
类型2:使用「维度查询/更新」组件自动维护版本,完整保留历史轨迹
本次实验帮助掌握了维度表管理的核心操作与设计思路,为构建规范、高效的数据仓库维度层奠定了基础。